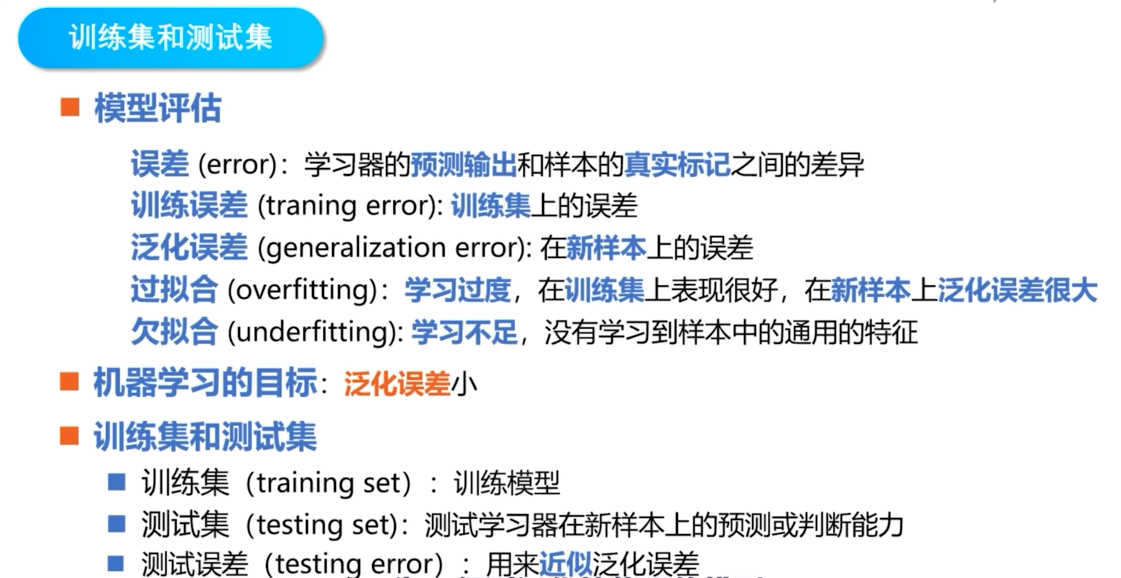
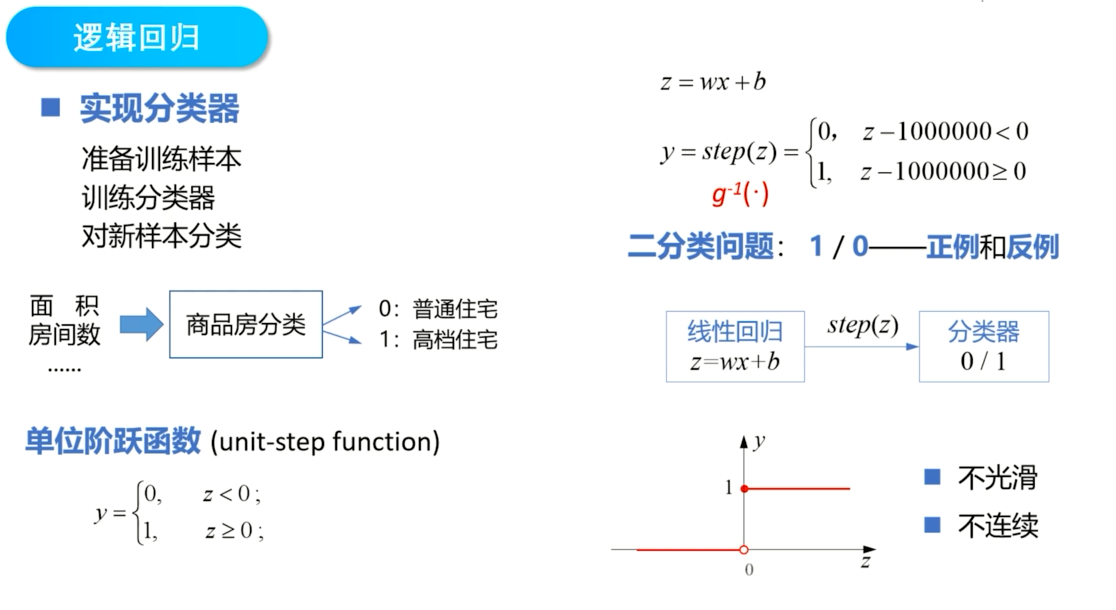
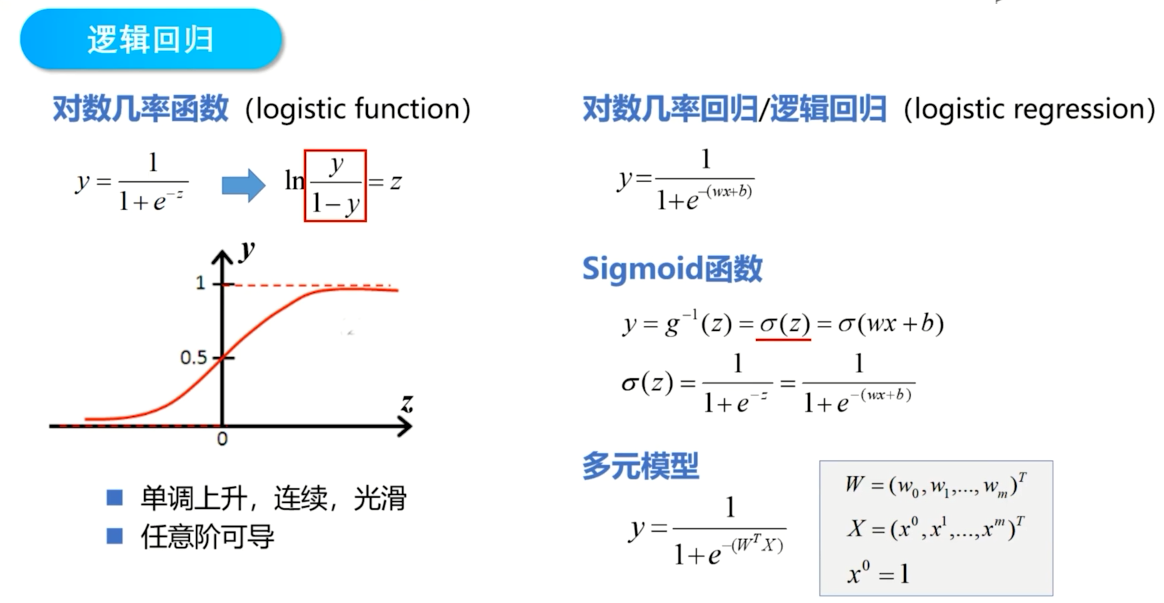
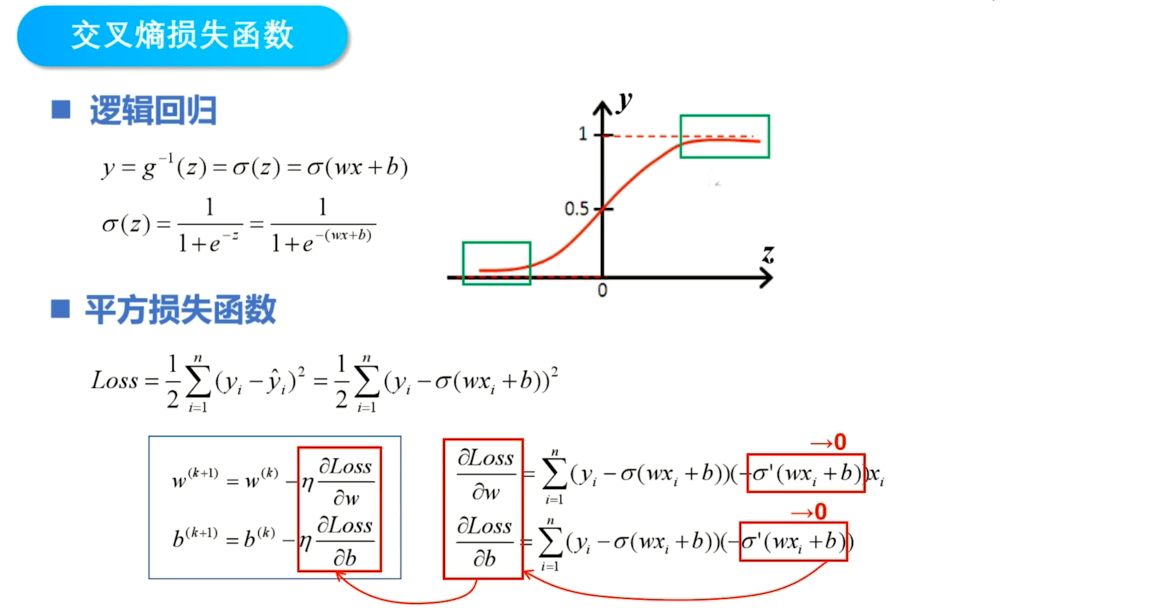
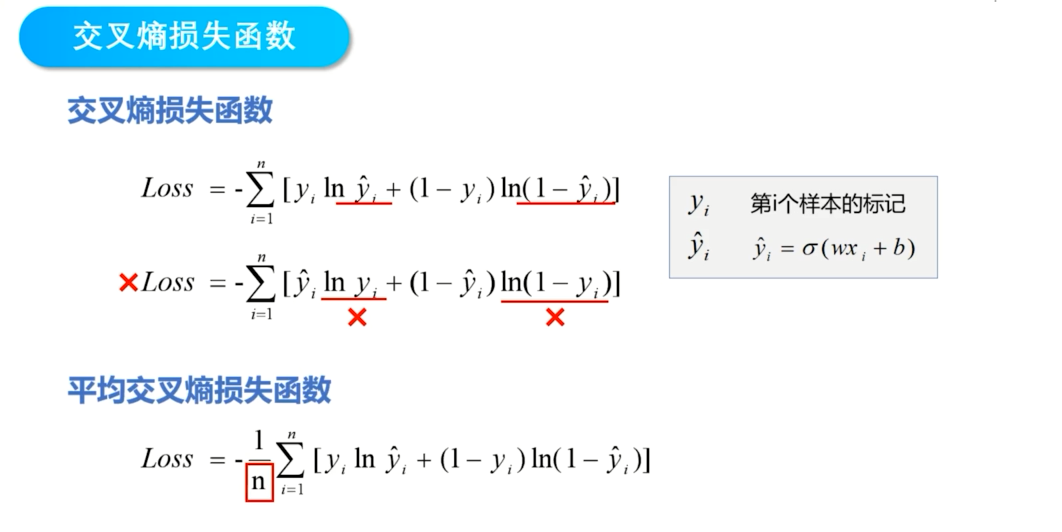
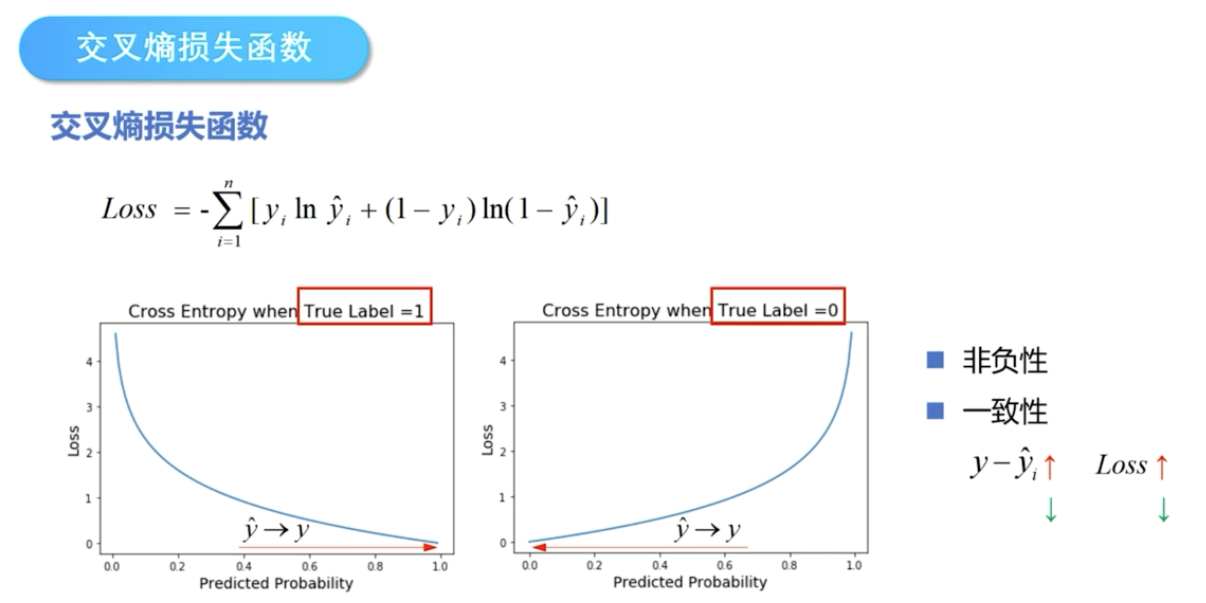
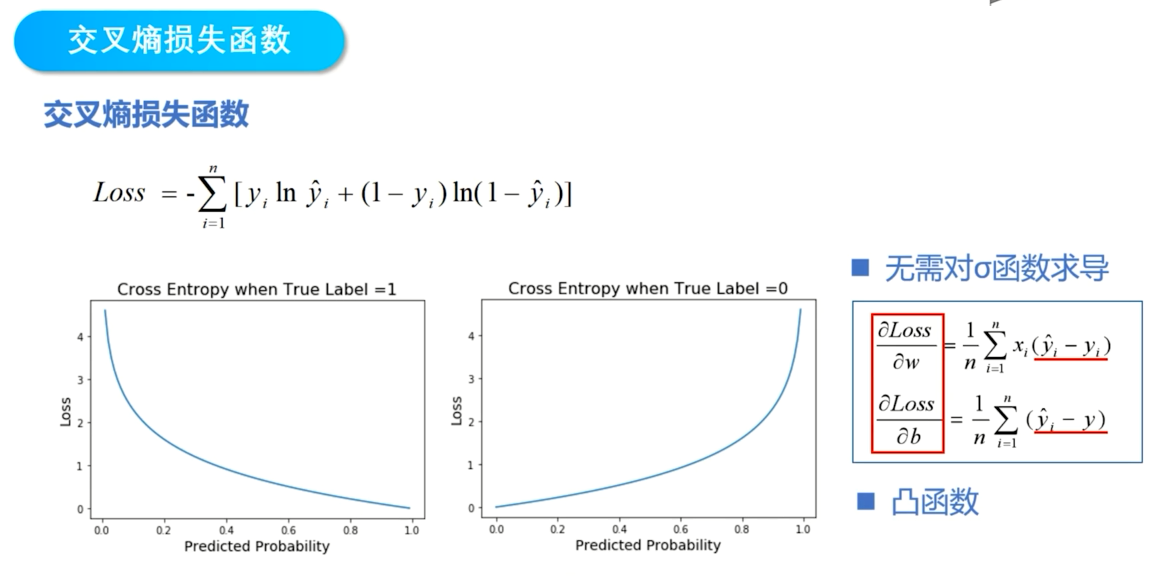
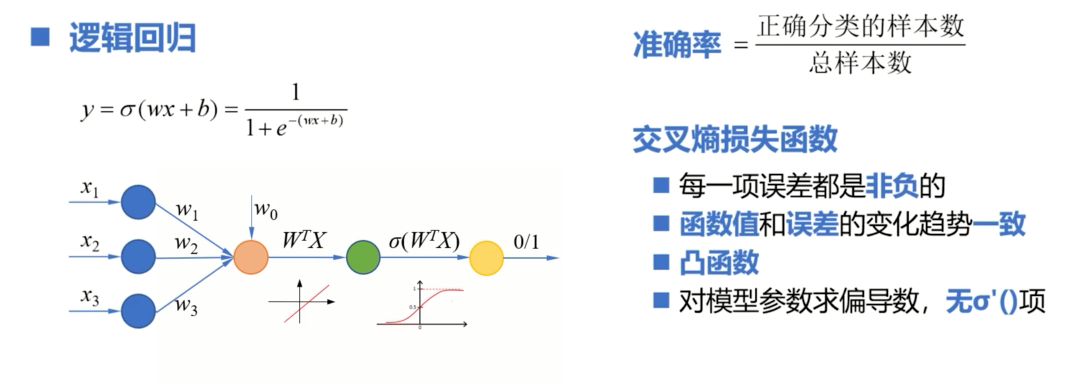
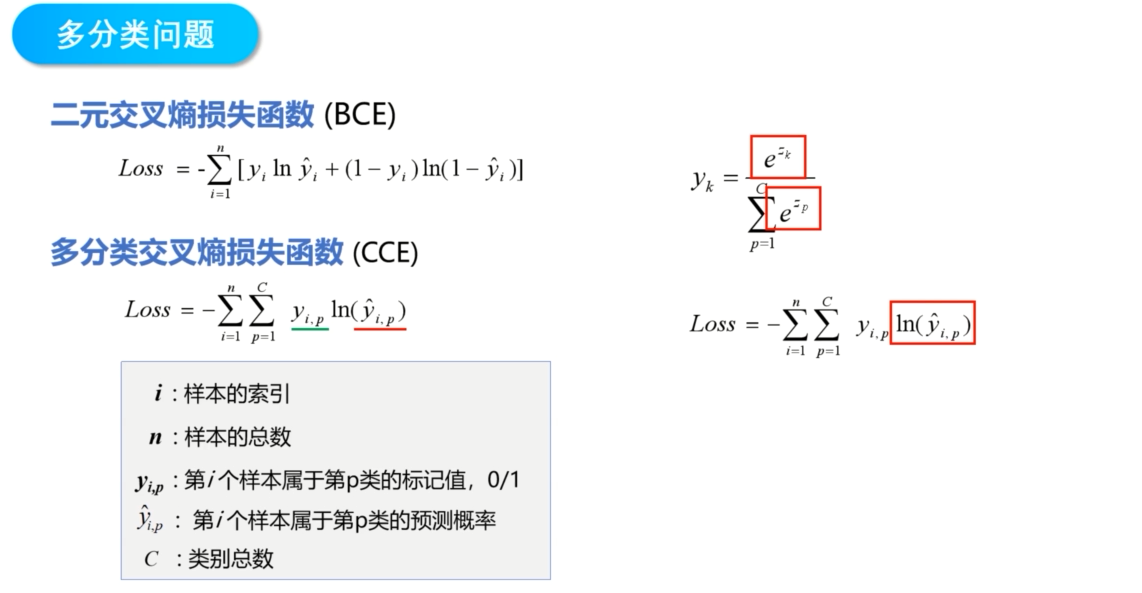
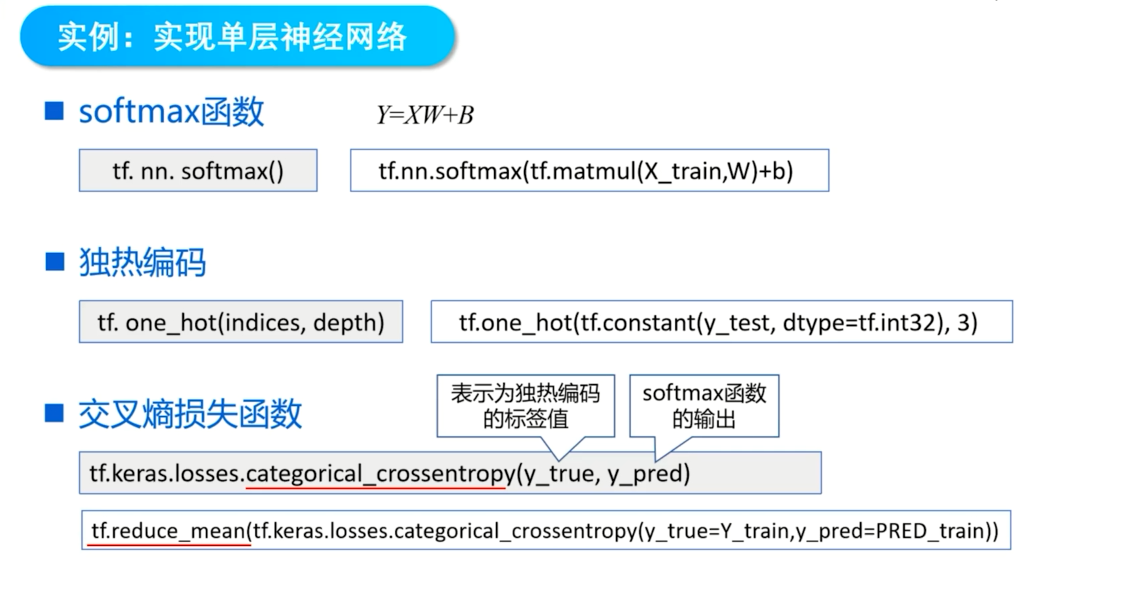
Sigmoid函数在大部分时候都非常平坦,在这些地方,导数接近于零,导致迭代更新时步长非常小,更新缓慢。而且在逻辑回归问题中,它的平方损失函数是非凸函数,容易陷入局部极小值。所以在逻辑回归问题中常使用交叉熵损失函数
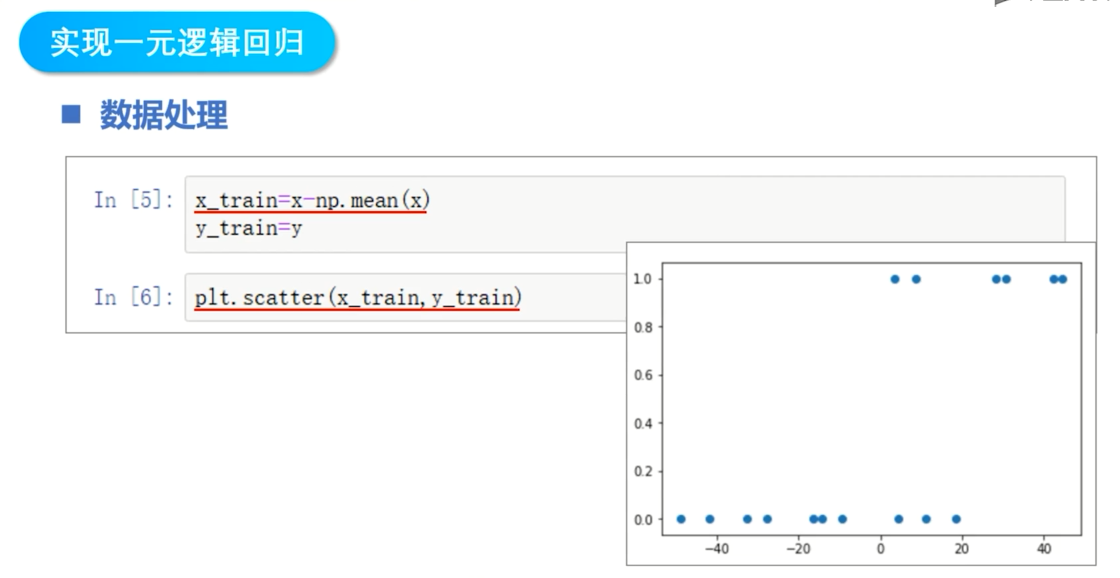
因为sigmoid函数是以零点为中心的,因此,在数据处理阶段,对这些的进行中心化处理,每个样本点减去他们的平均值
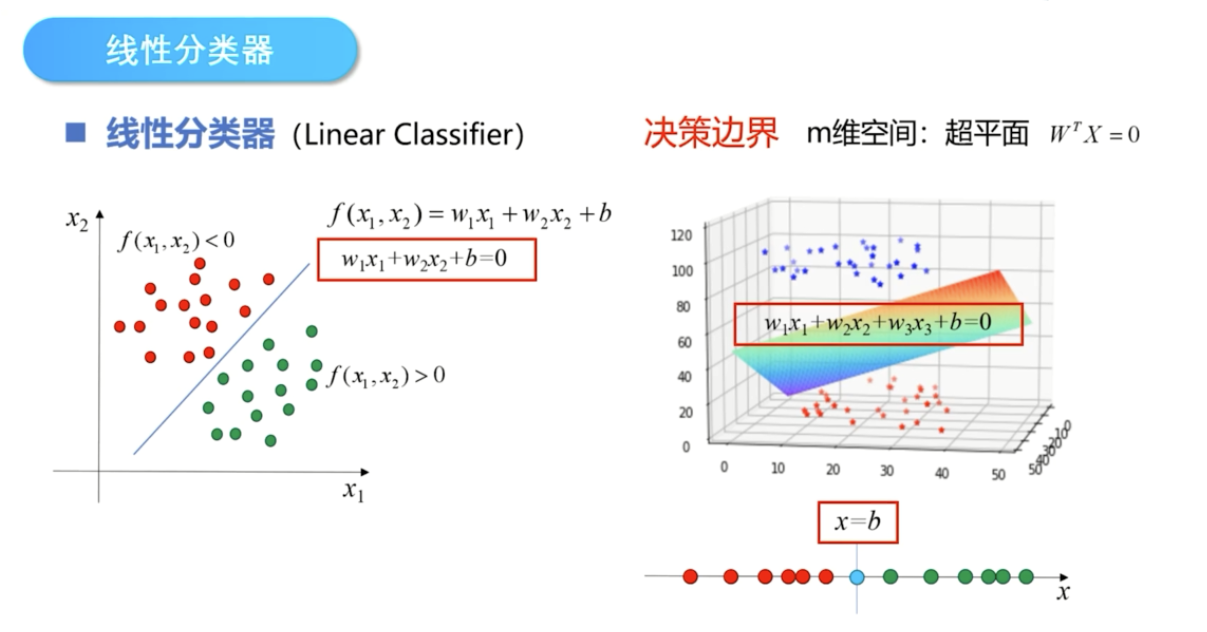
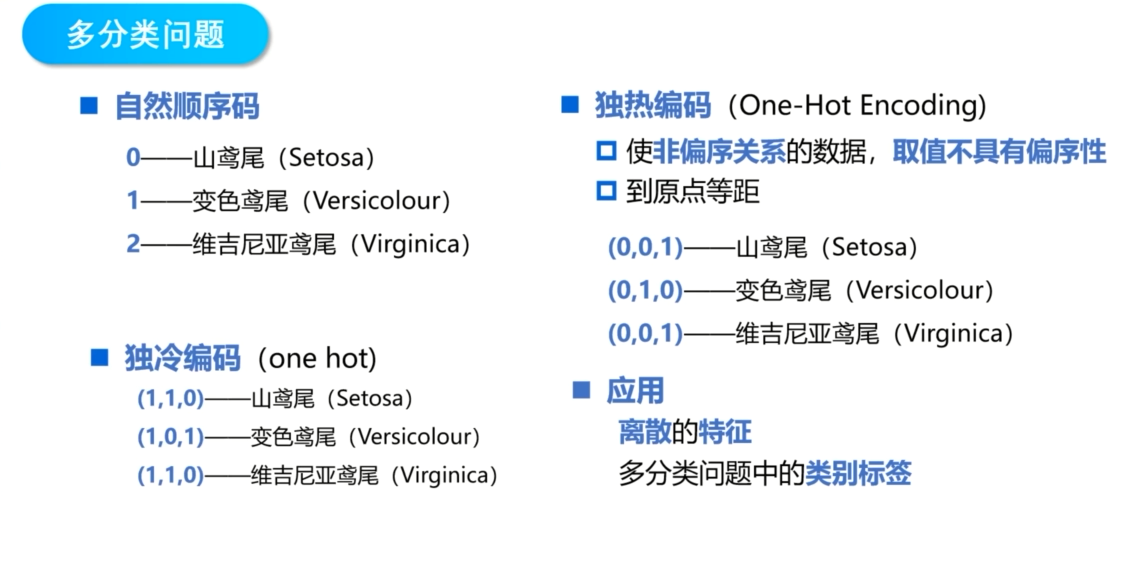
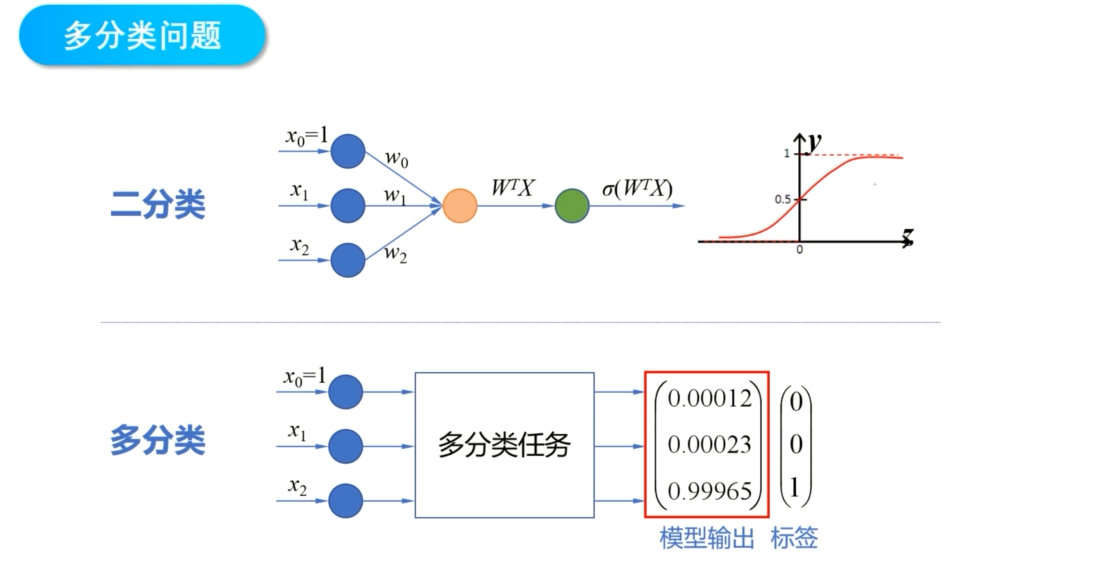
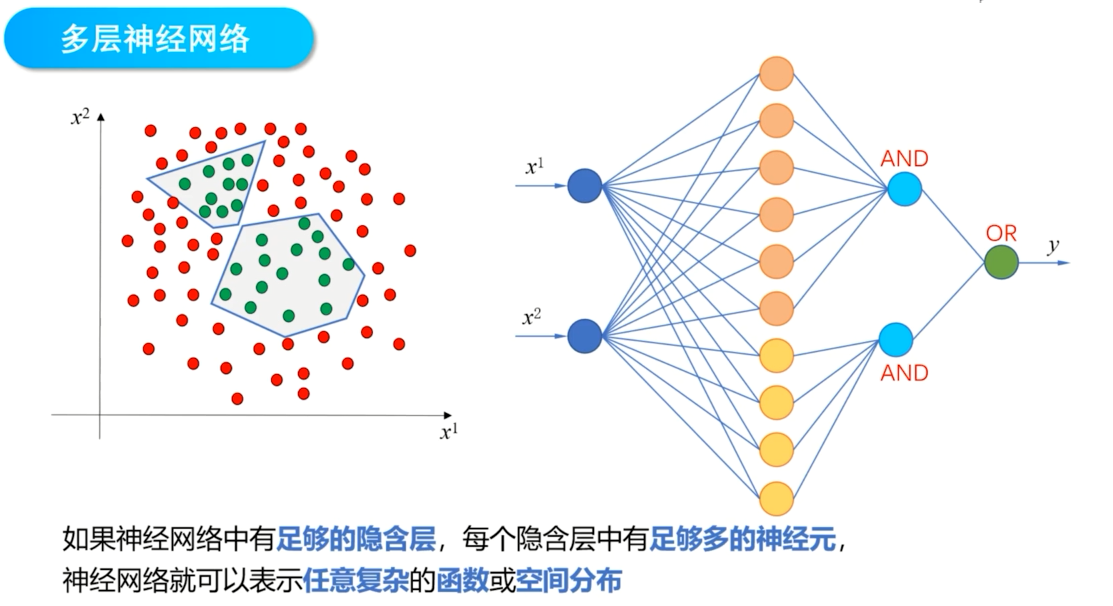
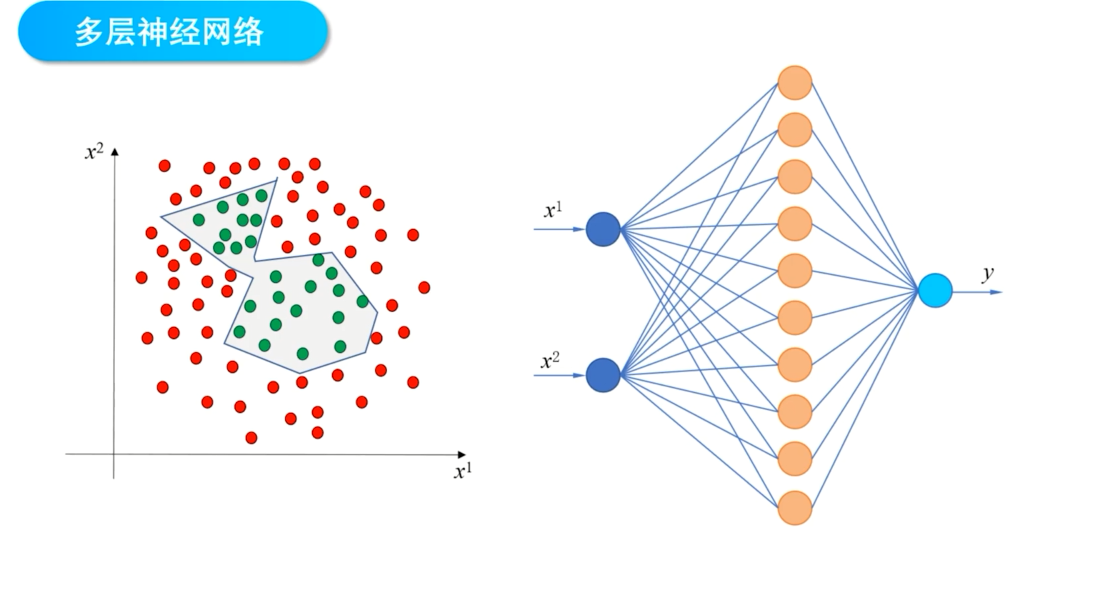
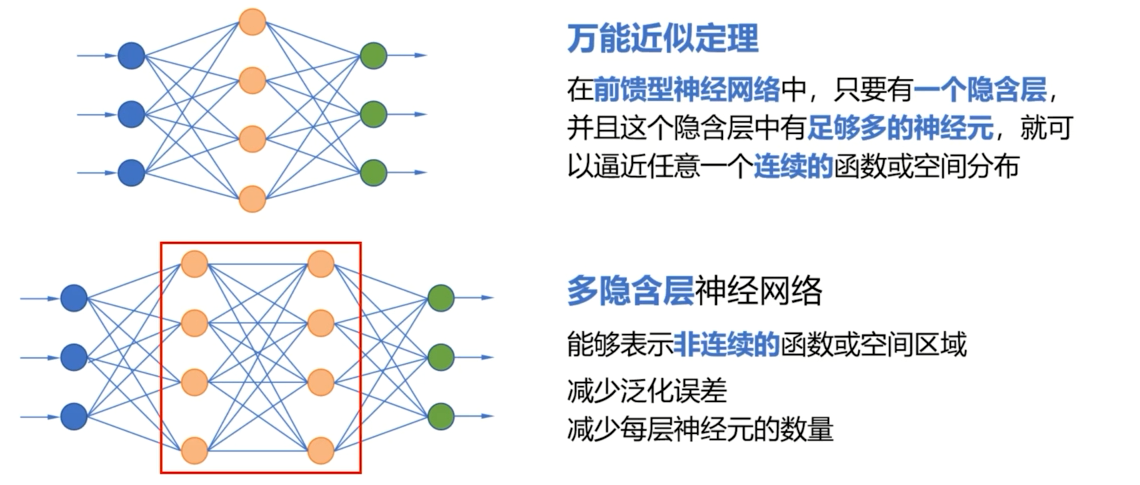
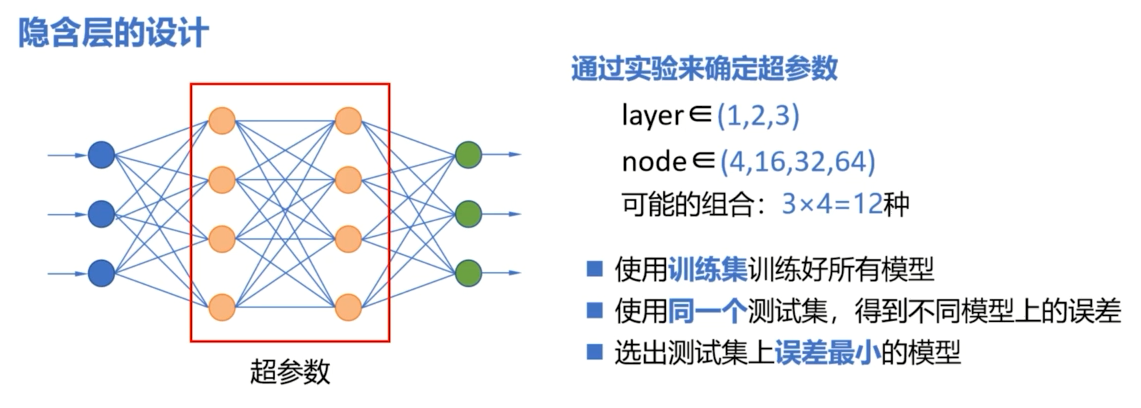
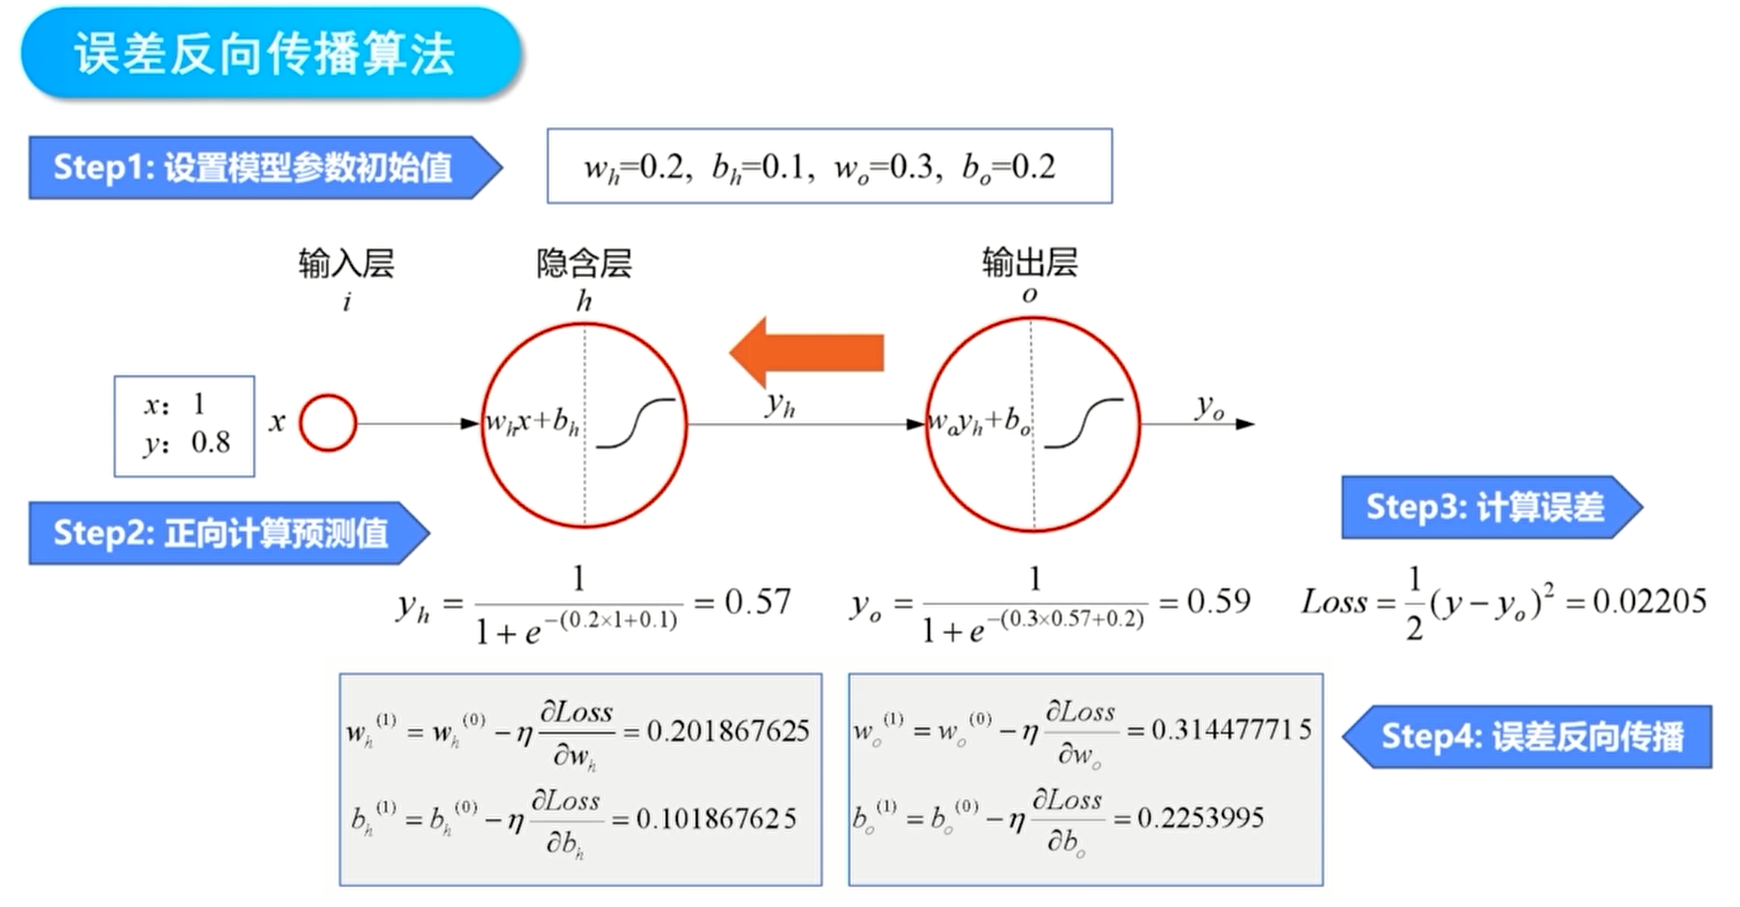
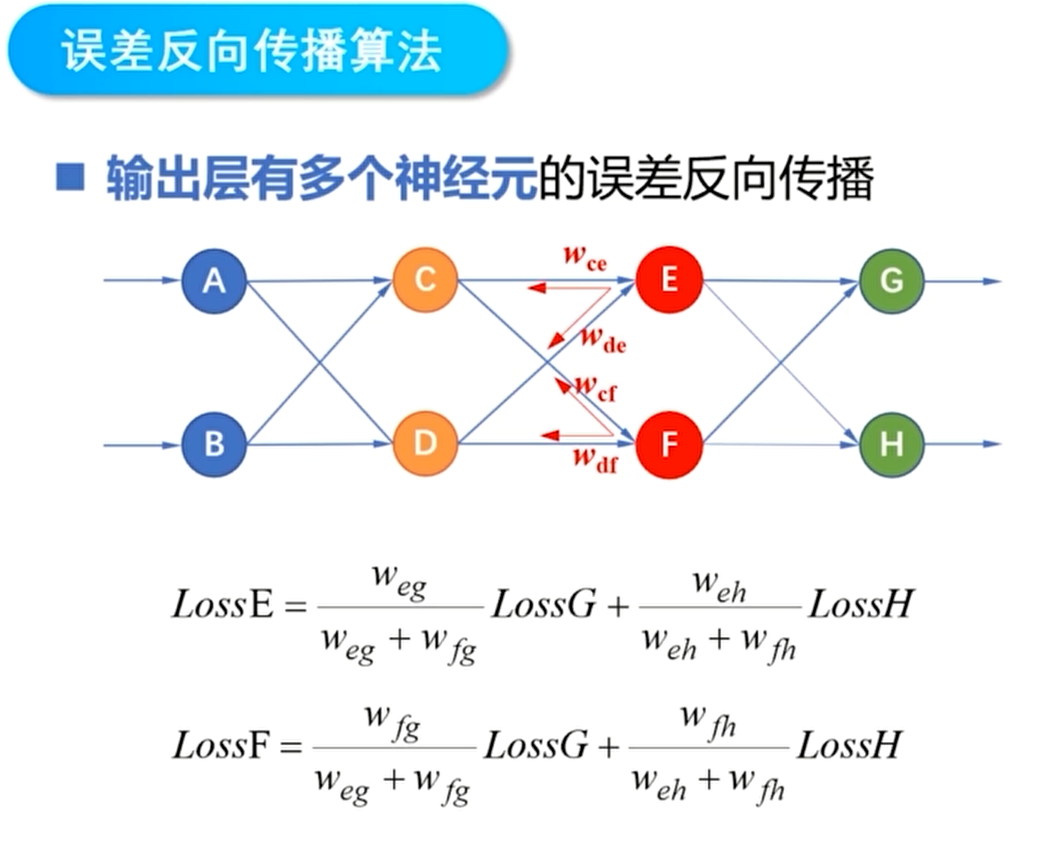
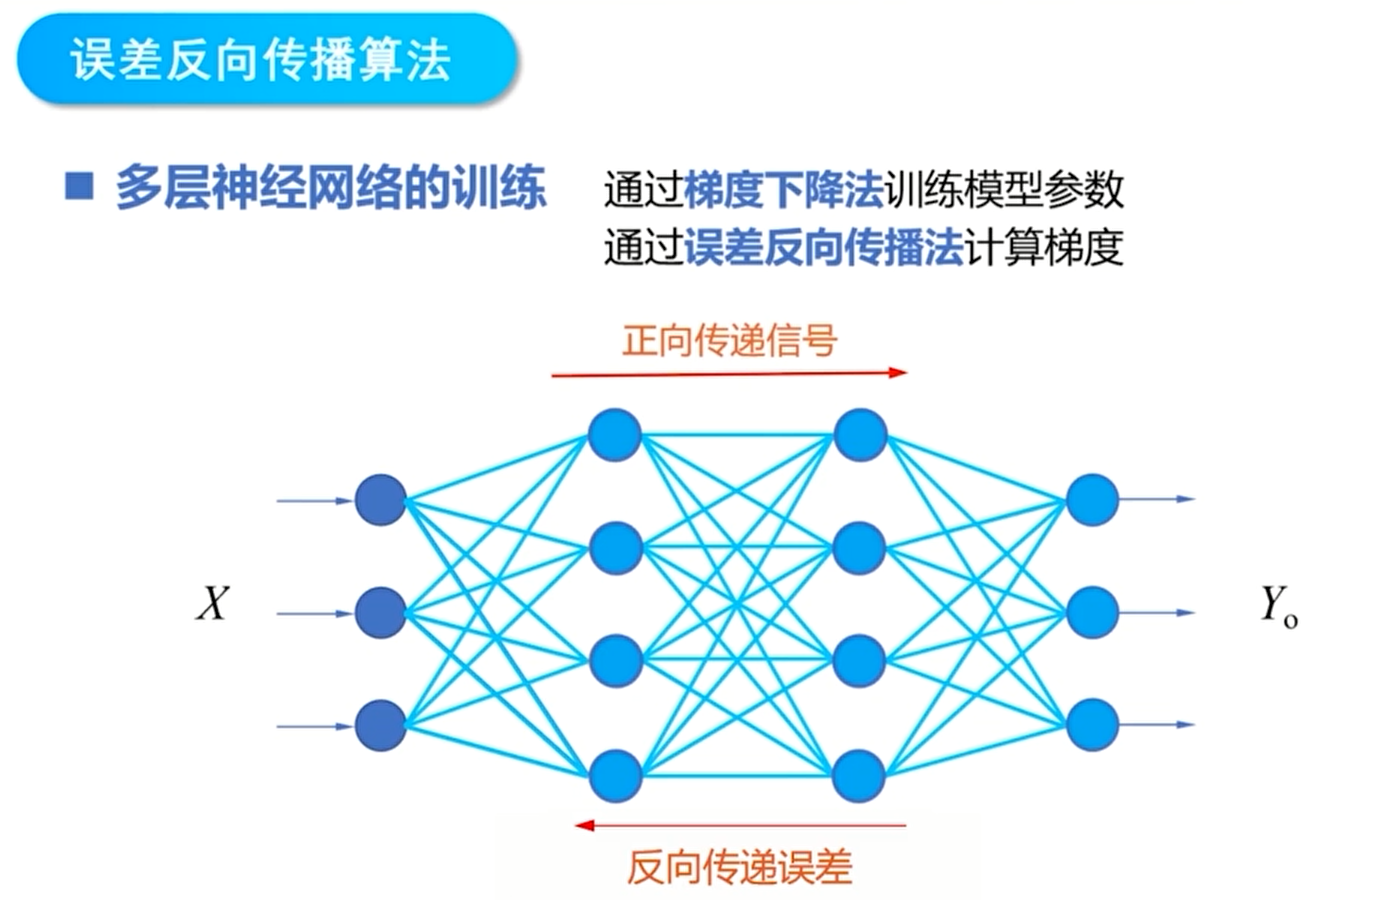
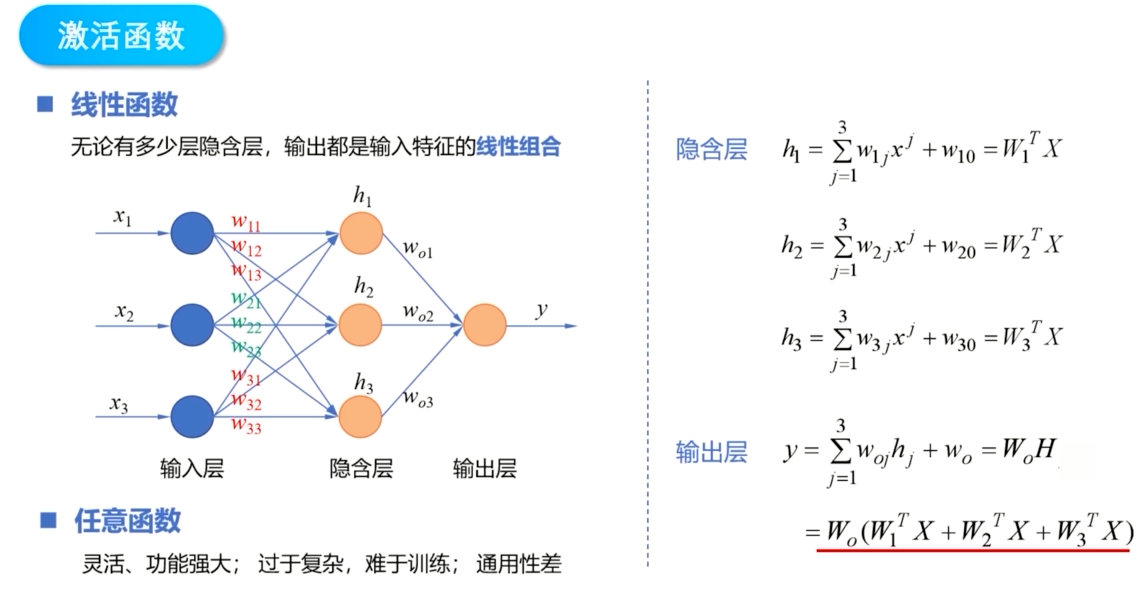
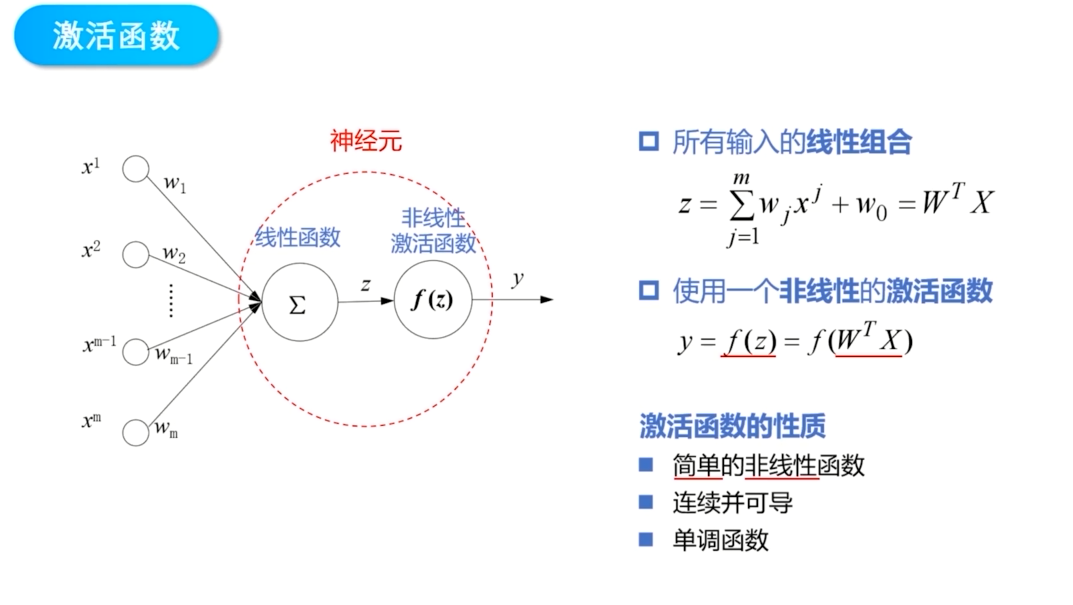
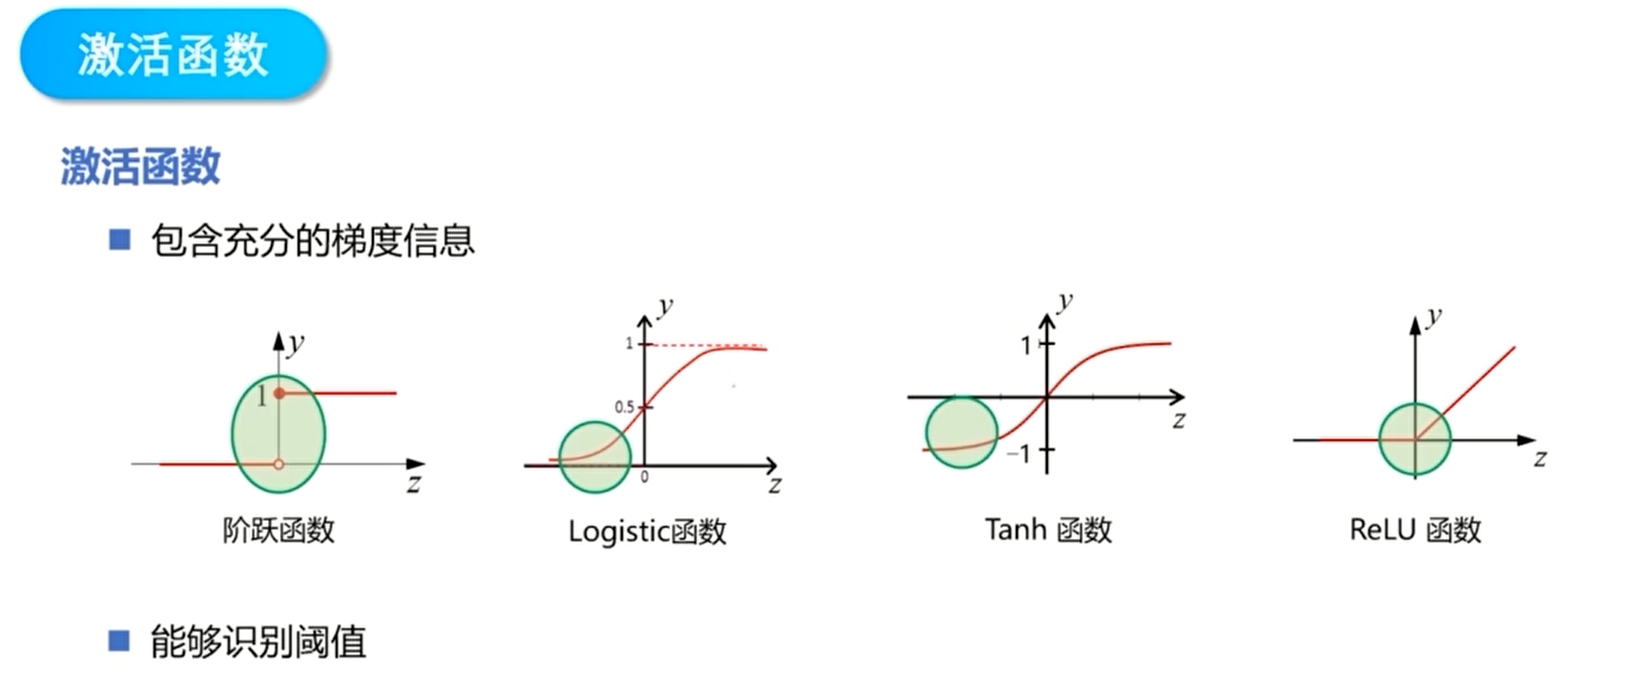
当激活函数是非线性函数时,多层神经网络就不再是简单的线性组合,而可以逼近各种复杂的函数和空间分布。需要连续可导,这样就可以使用梯度下降法来更新网络参数。同时应该是单调的,这样才能保证单层神经网络的损失函数是凸函数,学习算法更容易收敛。
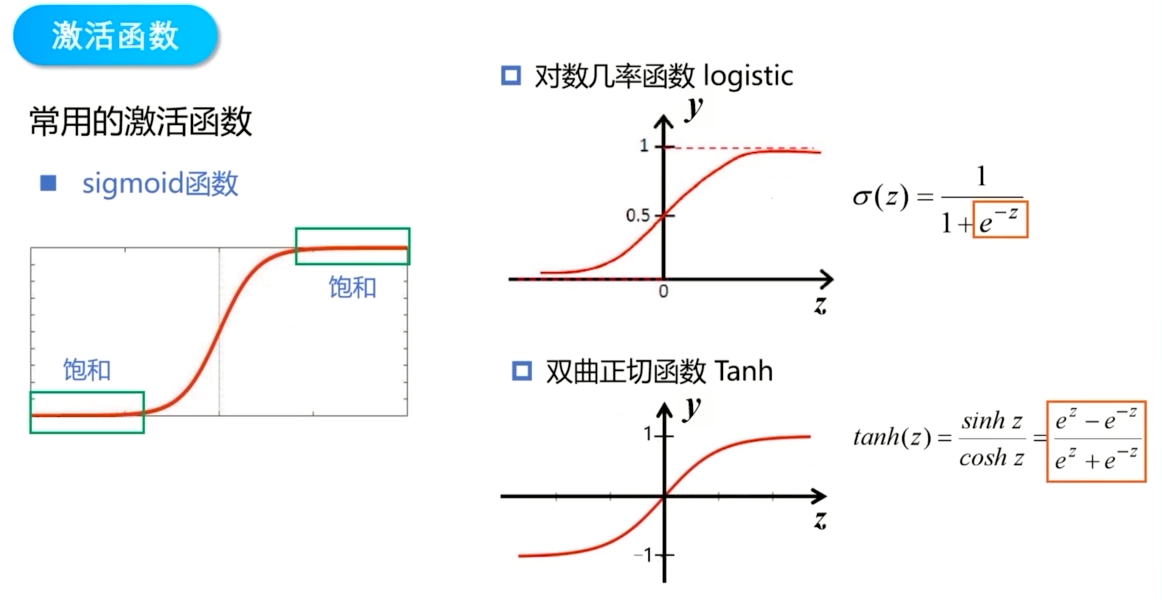
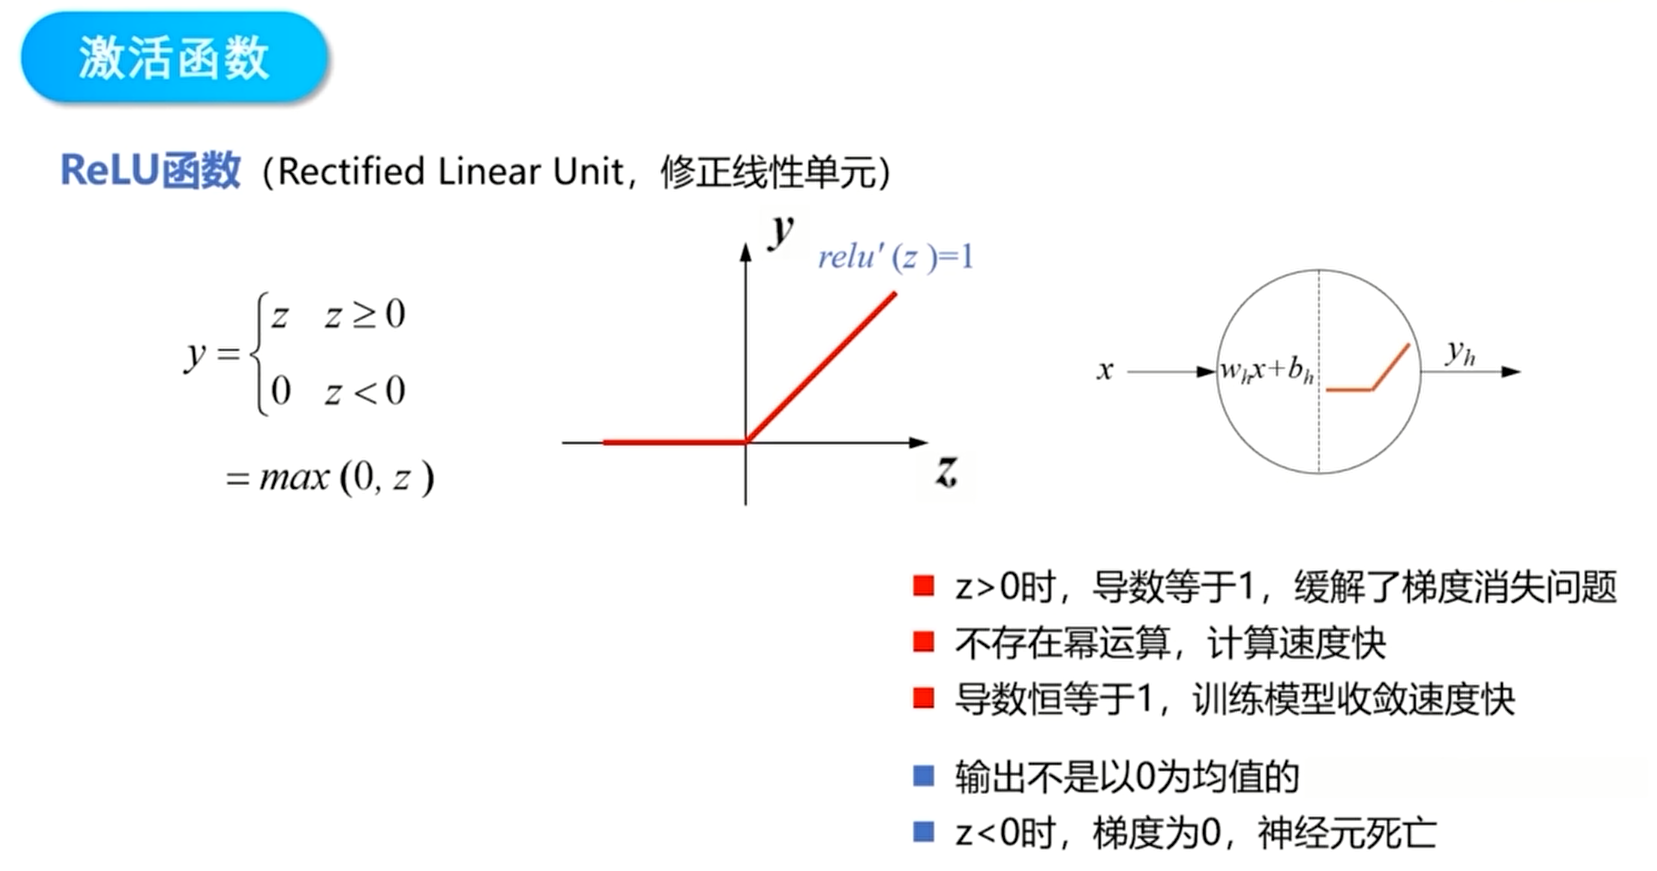
在多层神经网络中,上一层的输出是下一层的输入logistic函数的输出范围是从0到1之间,不是以0为中心的,这就会是的它后面一层神经元的输入发生偏移,可能导致梯度下降的速度变慢。为了避免这个问题,在隐含层,可以使用双曲正切函数来代替logistic函数。但是在这两个函数中,都需要进行幂运算,计算复杂度有点大。采用误差反向传播算法更新网络参数时,所需的训练时间会比较长。
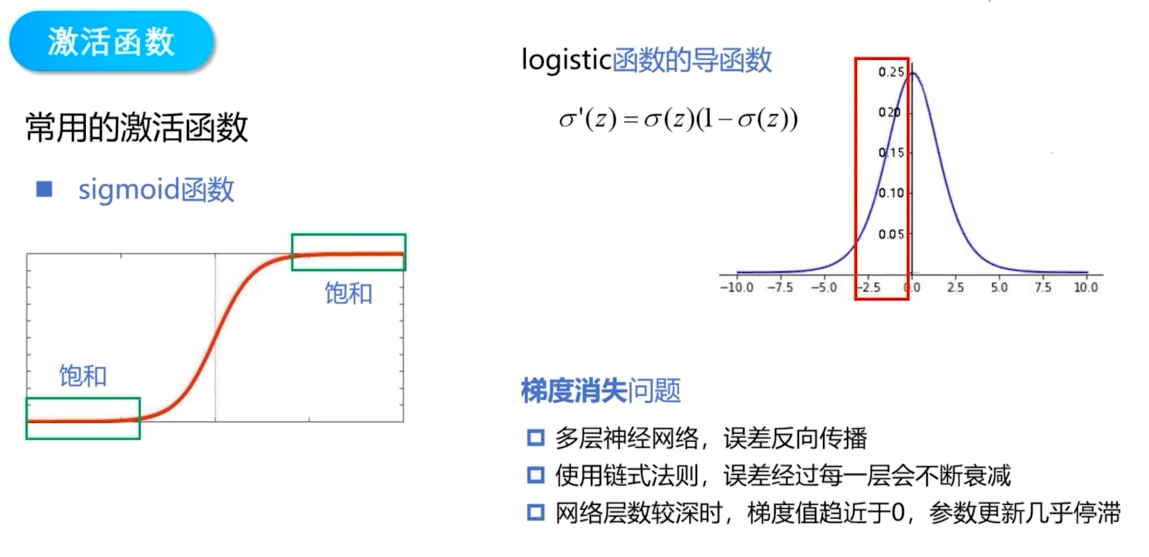
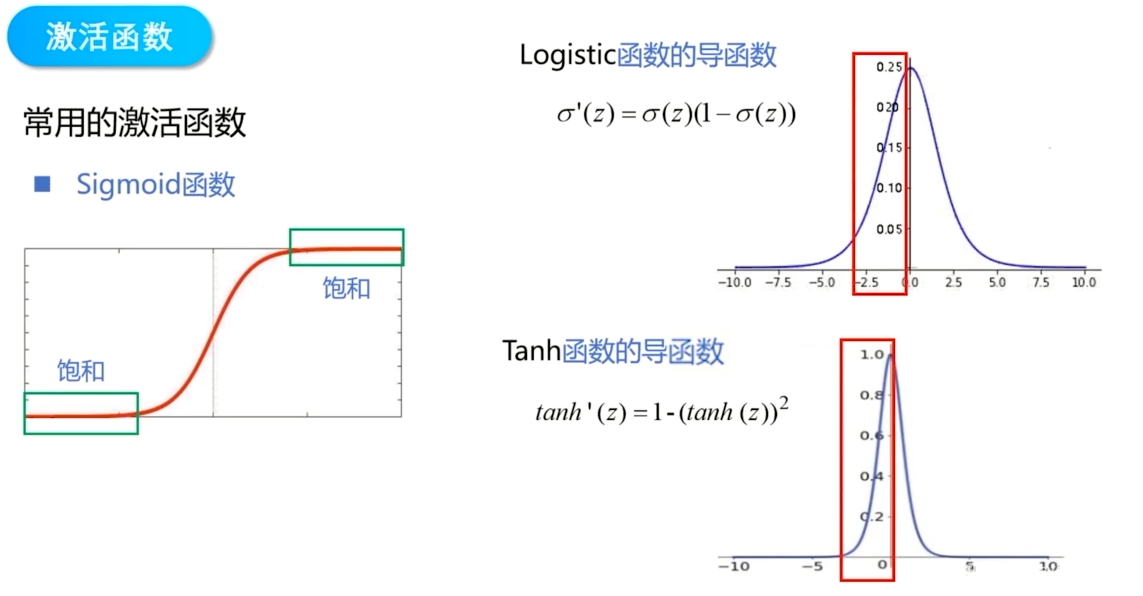
另外,这两种sigmoid函数的导函数的取值范围都在0到1之间,会存在梯度消失的问题。
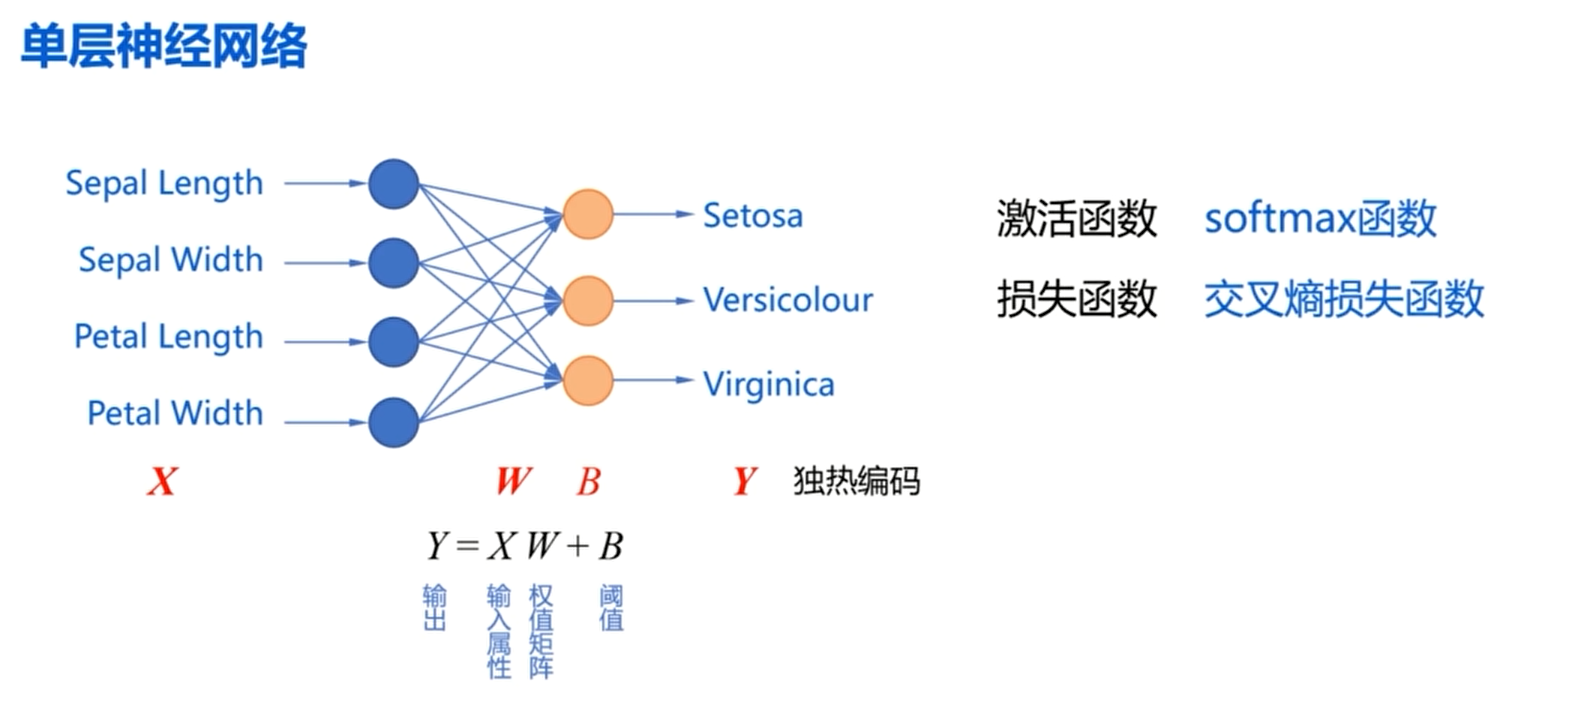
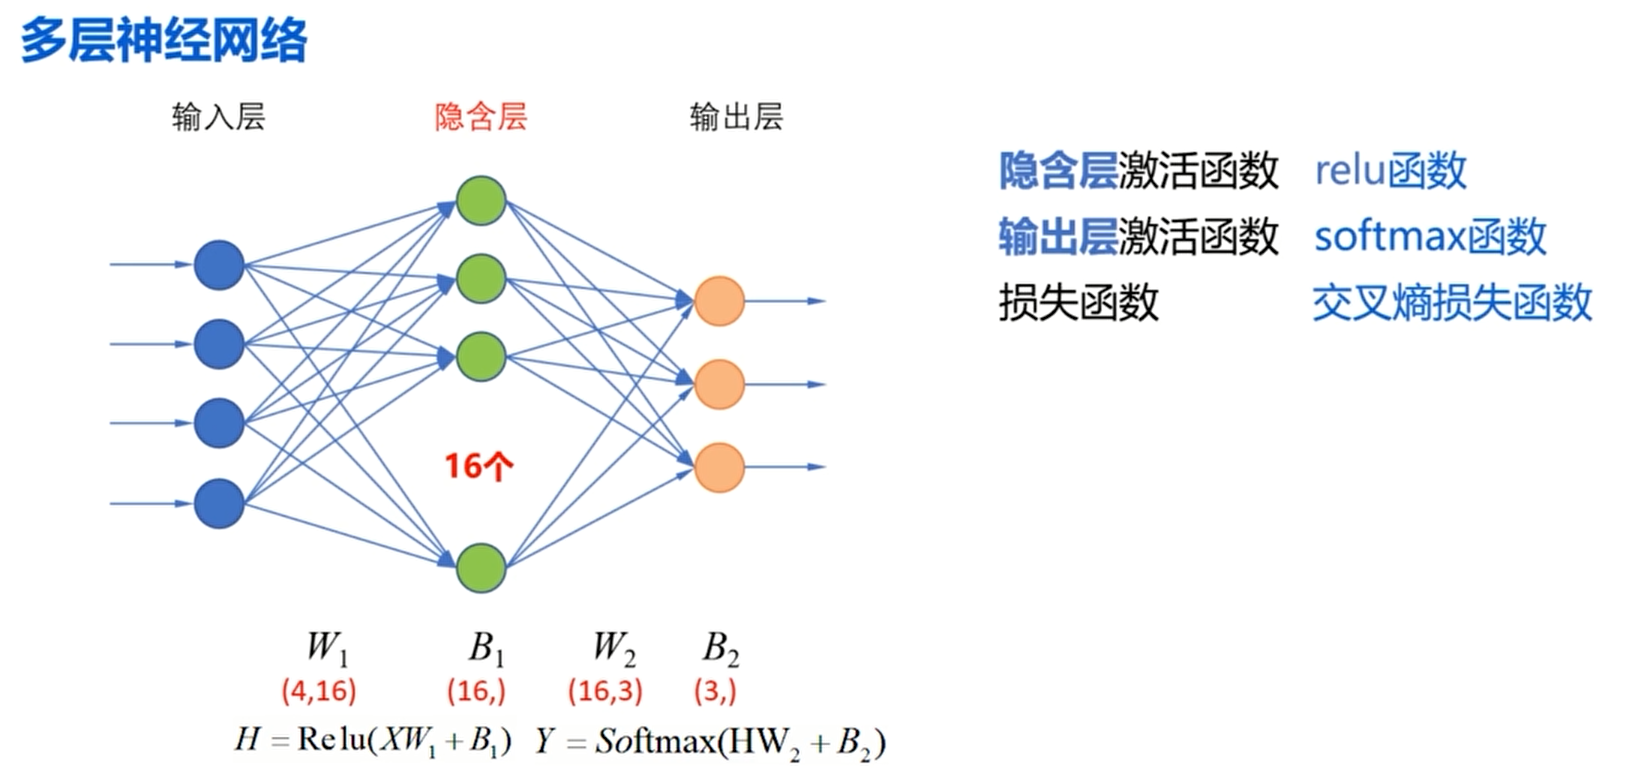
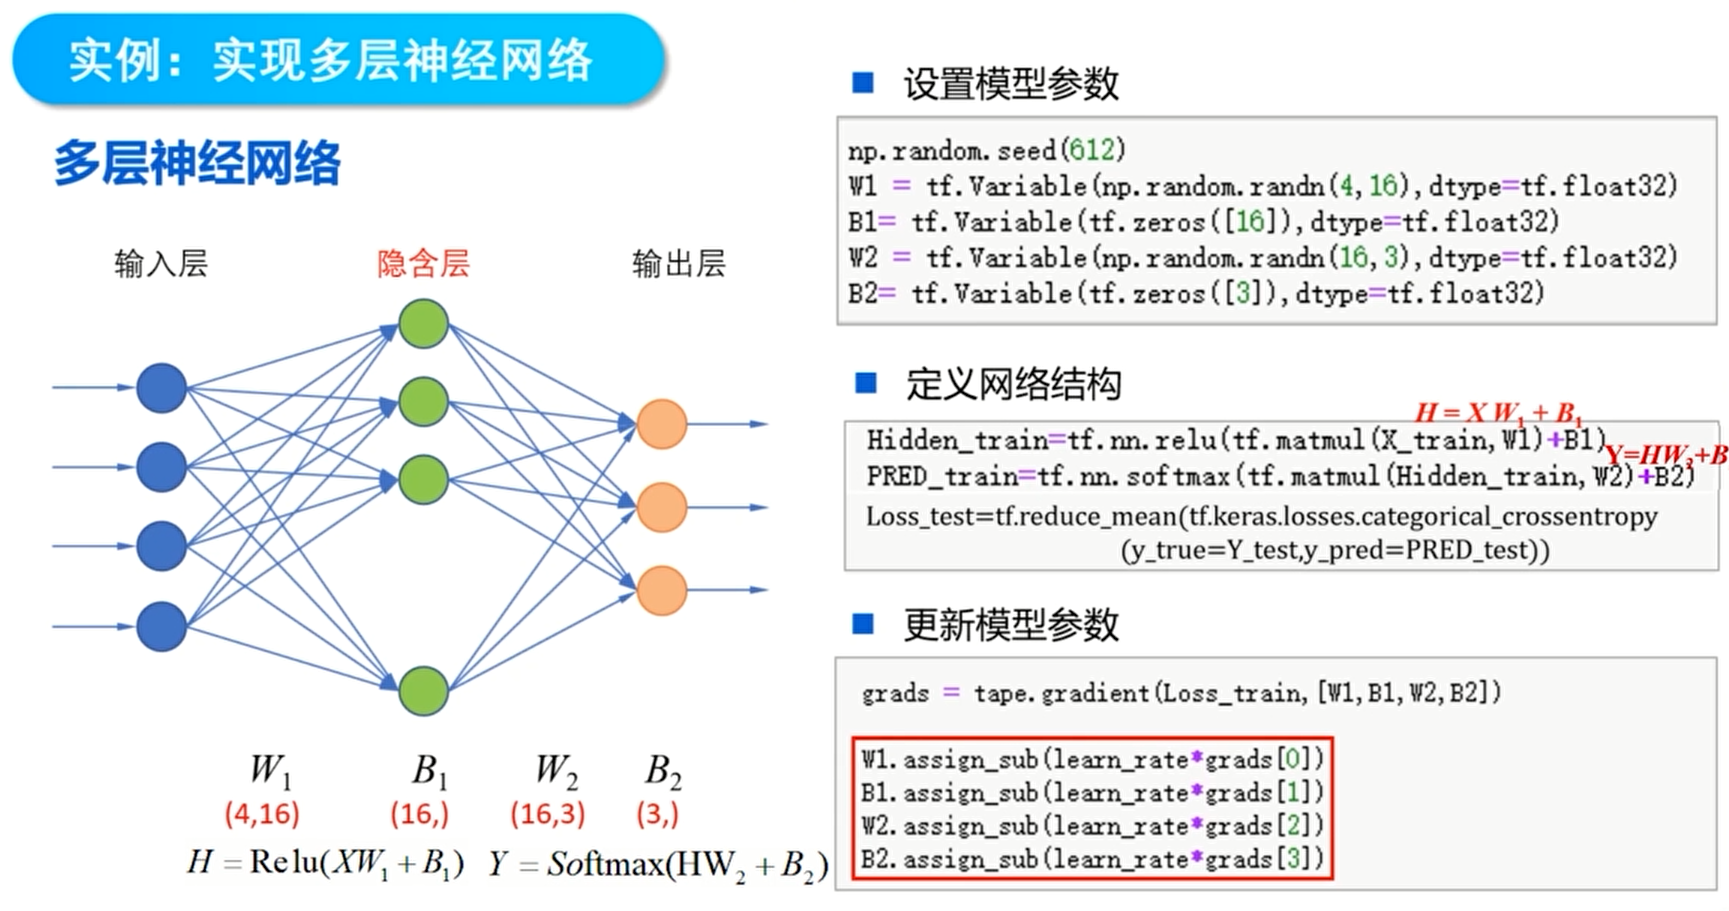
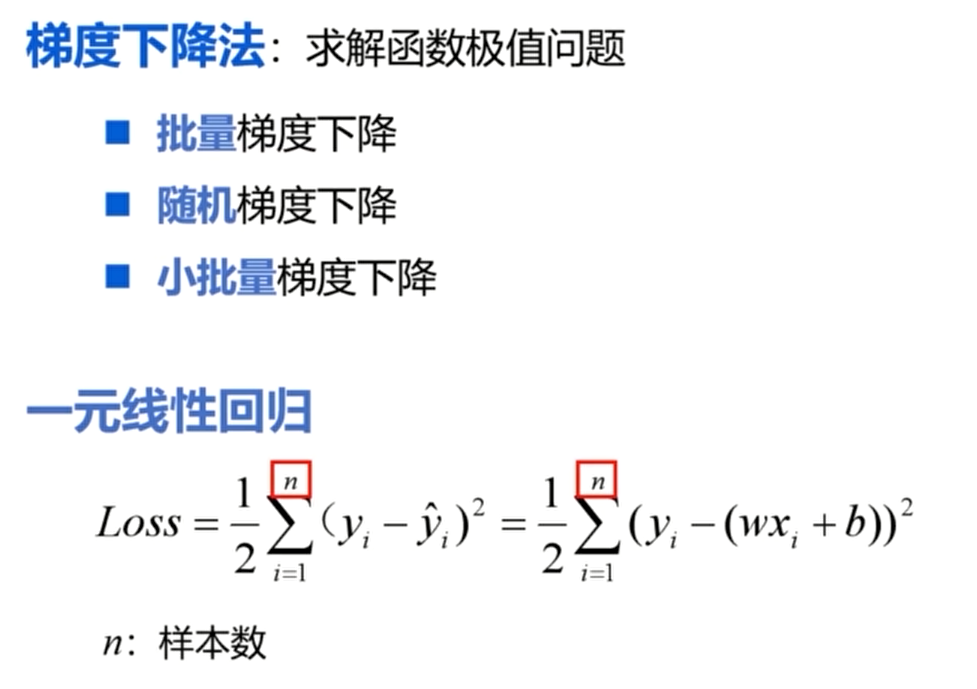
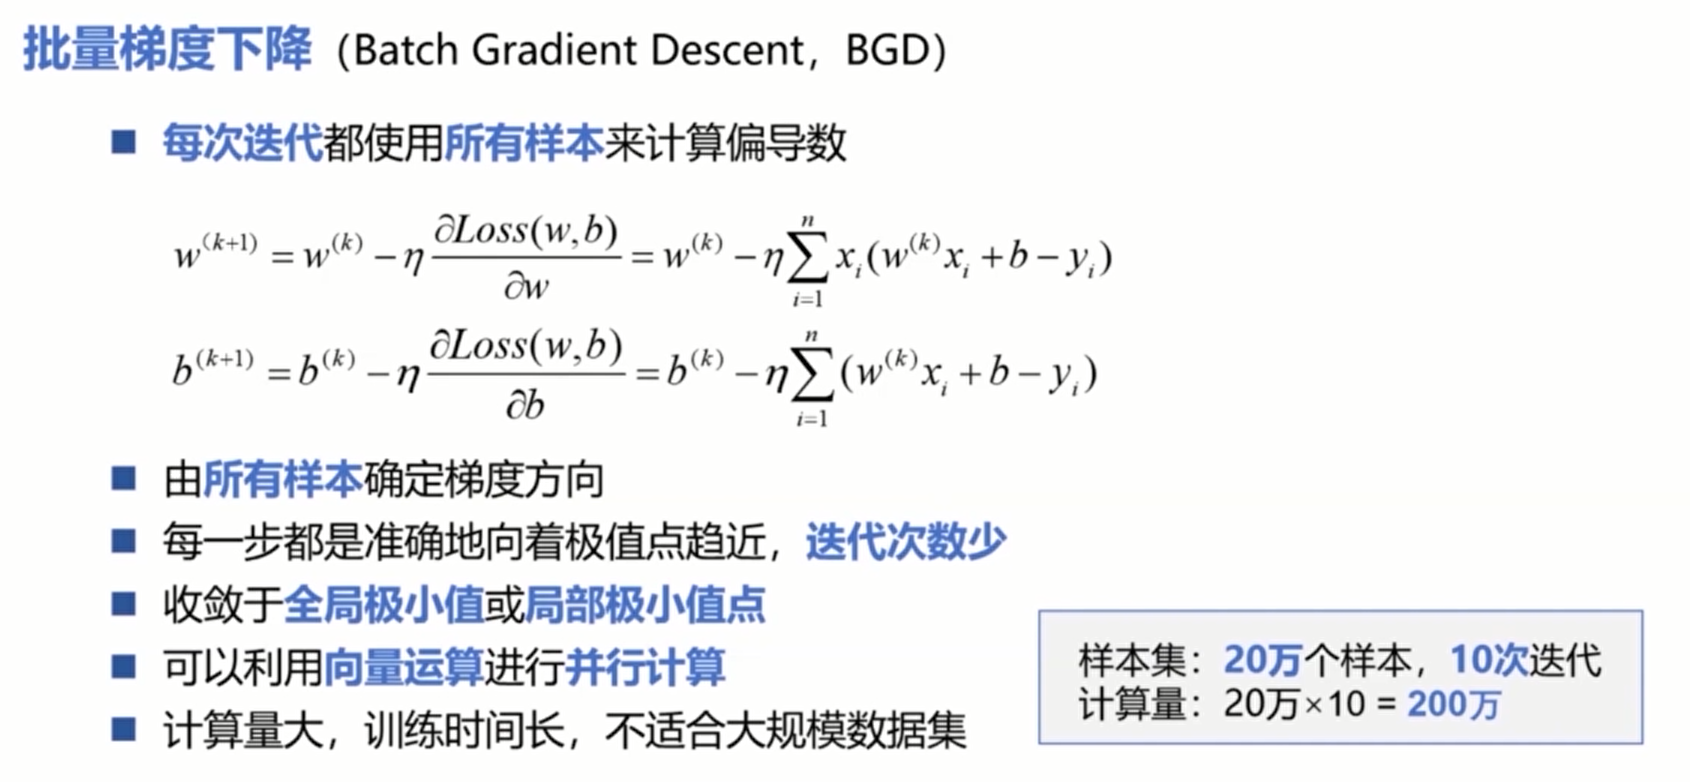
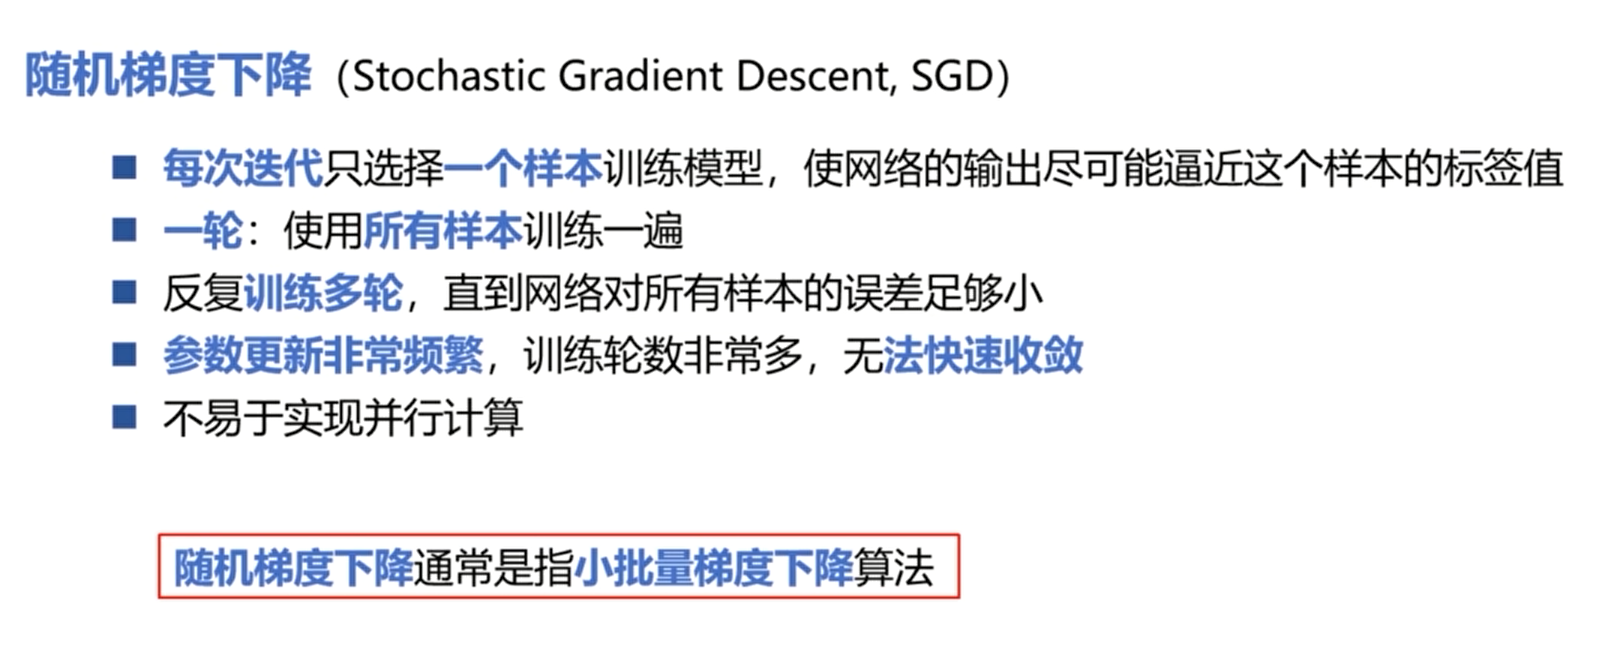
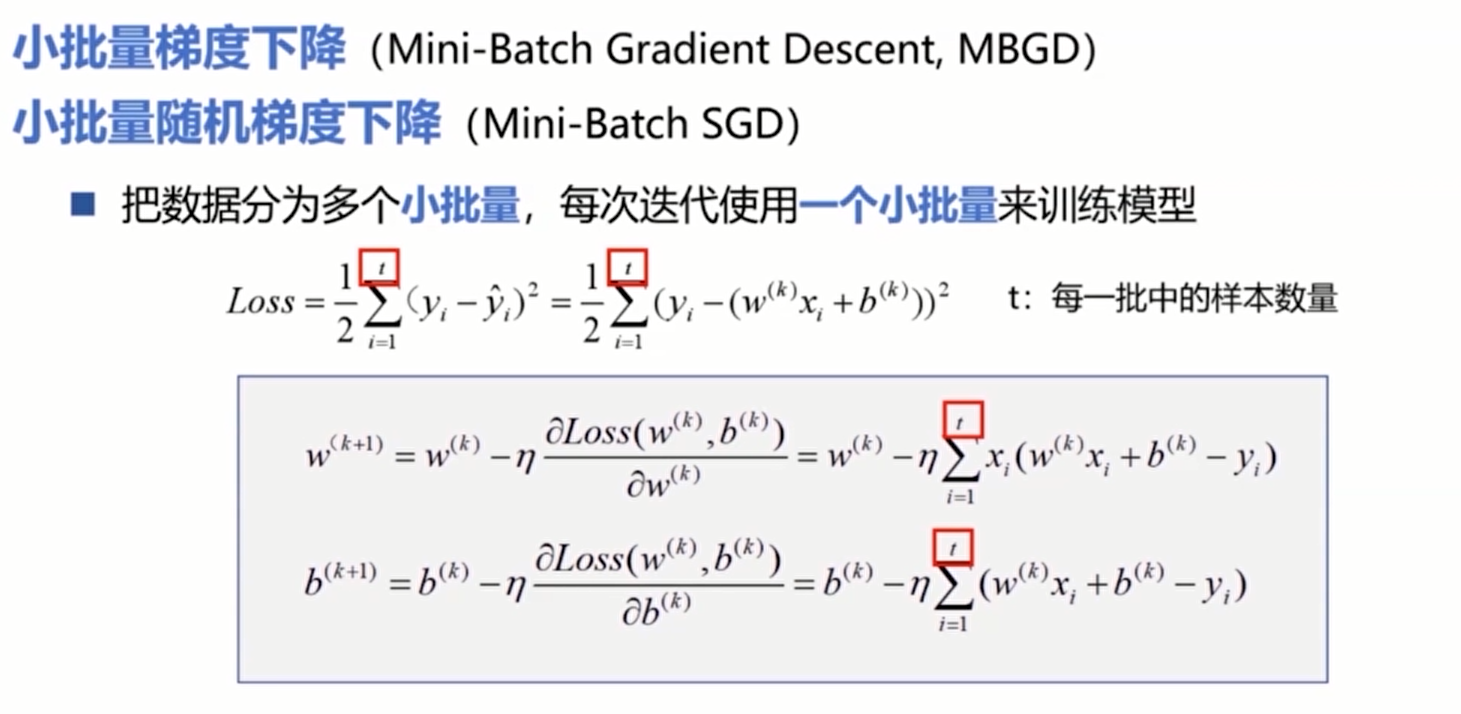
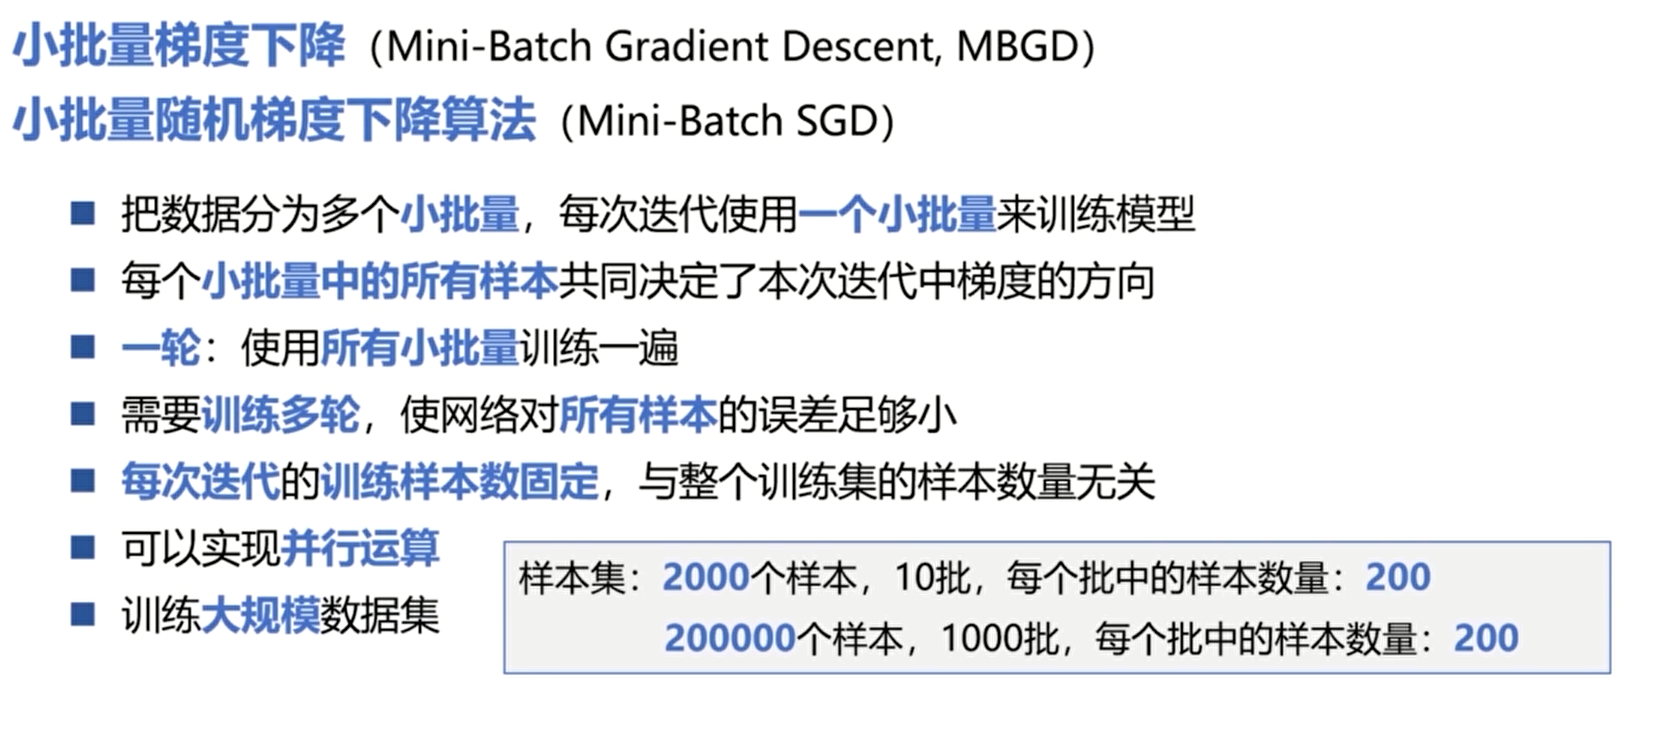
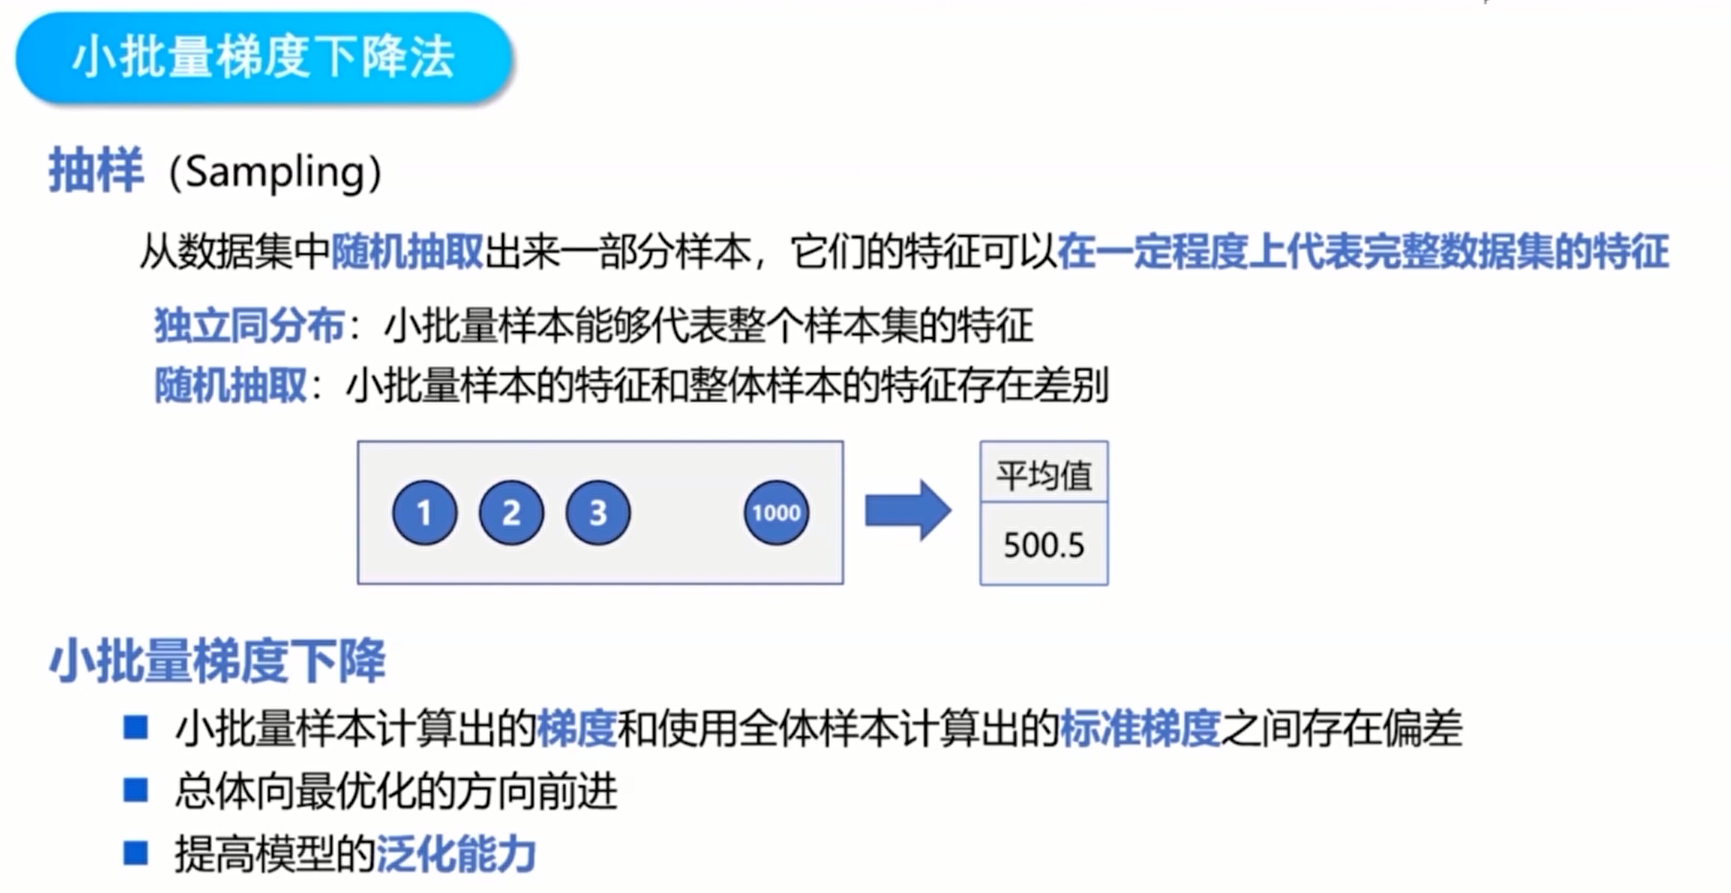
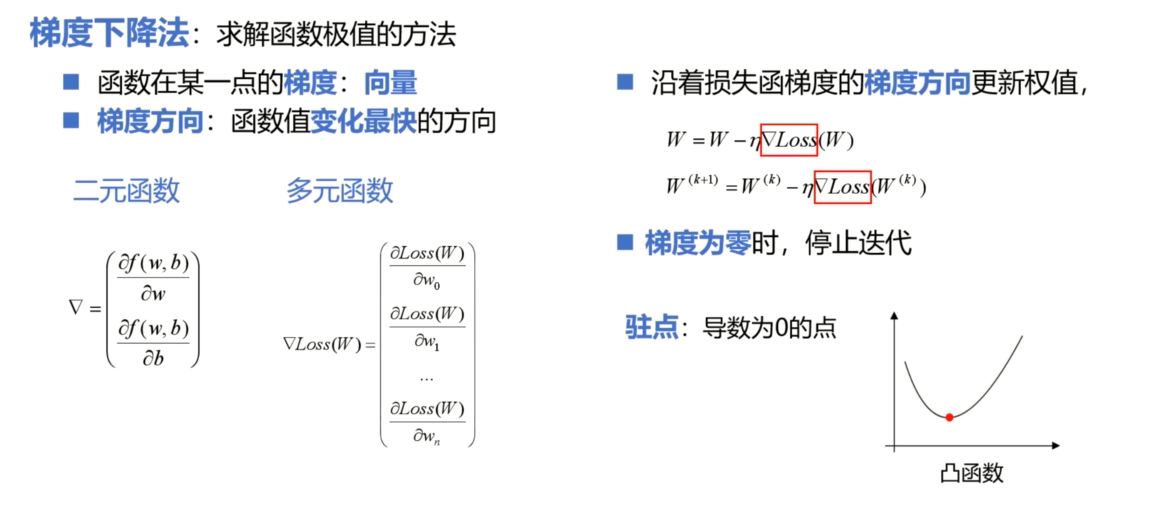
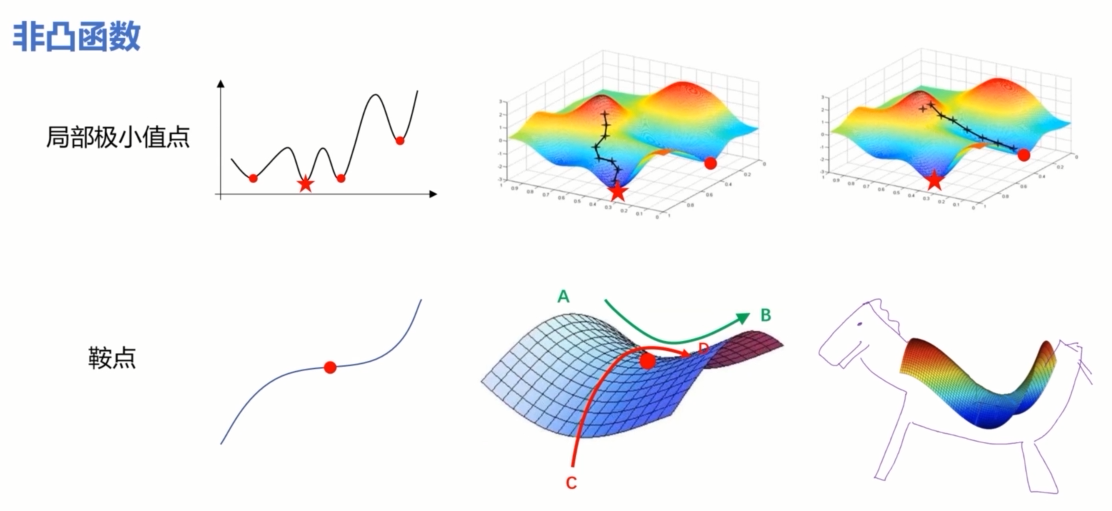
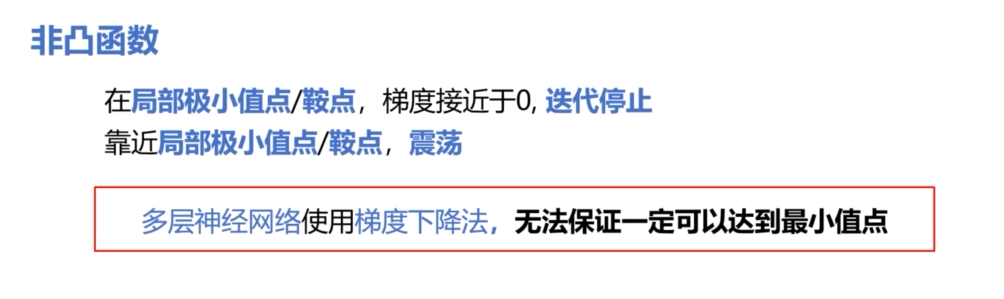
由于多层神经网络的损失函数不是凸函数,而是复杂的非凸函数,可能有多个极值点,梯度下降算法容易陷入局部极小值点或鞍点,所以需要对其进行优化。
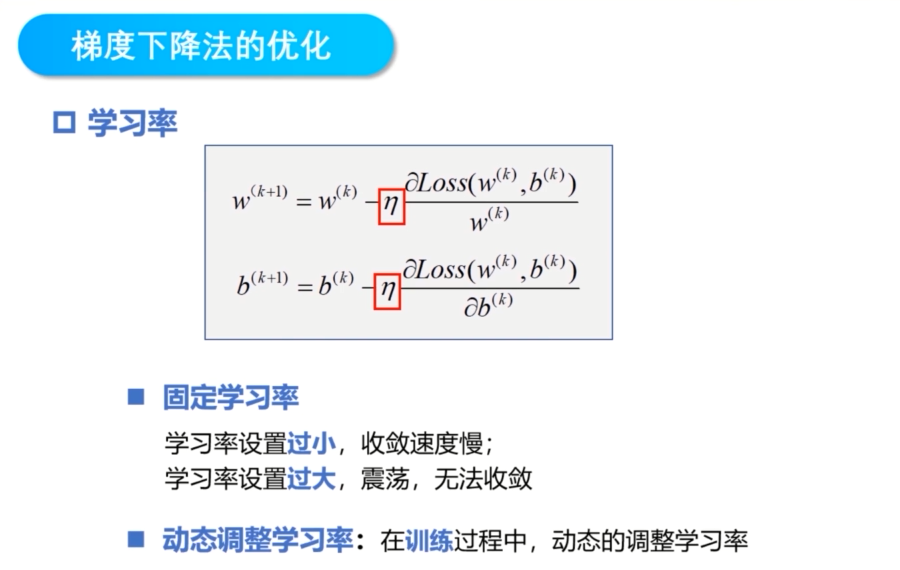
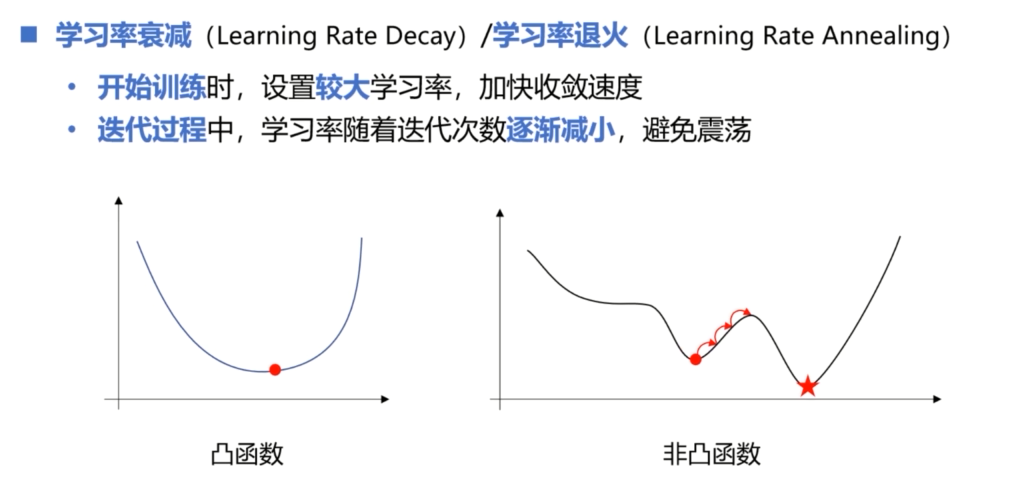
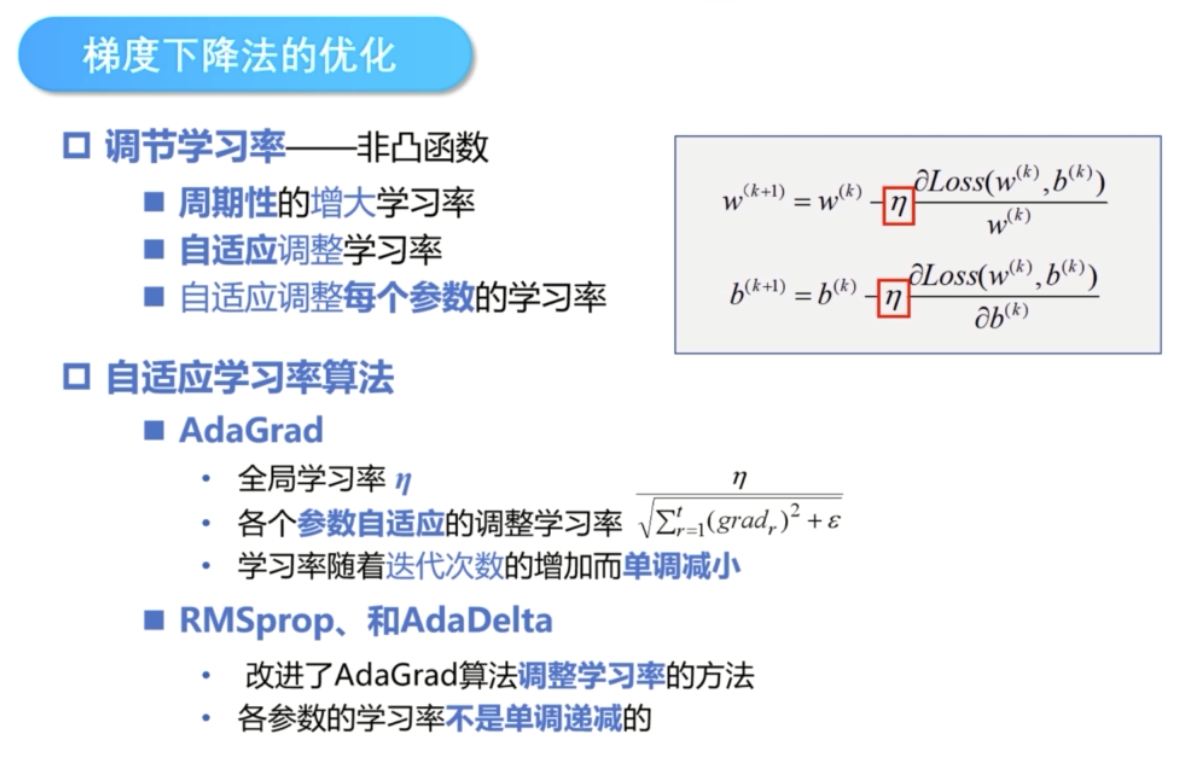
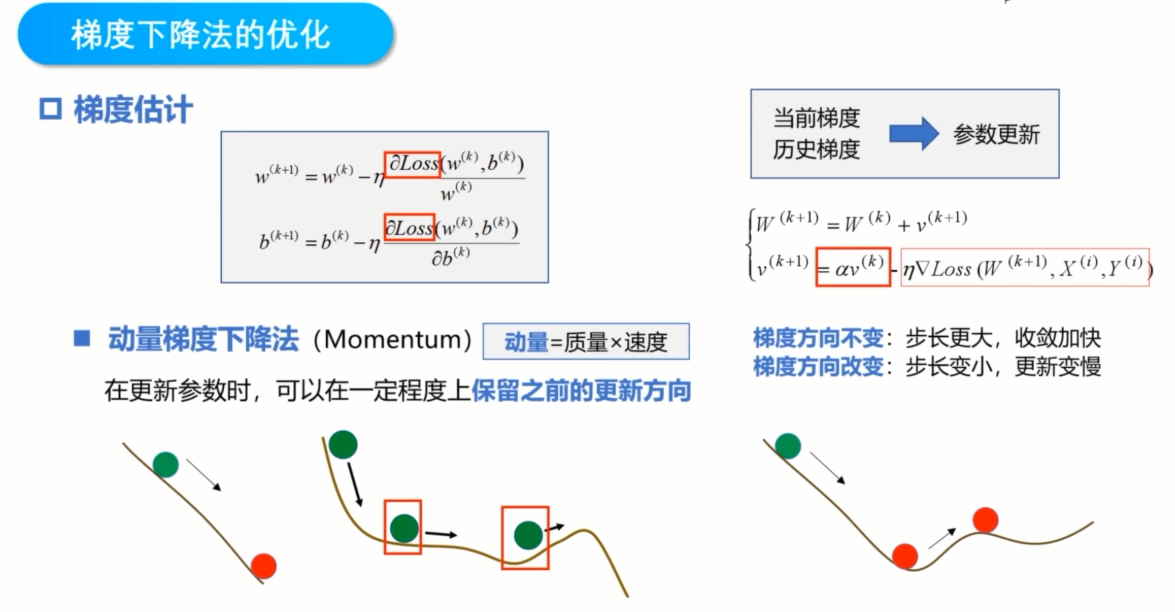
动量梯度下降算法有可能由于积累的动量较多,虽然可以越过局部极小值点,避免陷入局部极小值点,但也有可能越过全局最小值点,所以出现了牛顿加速梯度算法。
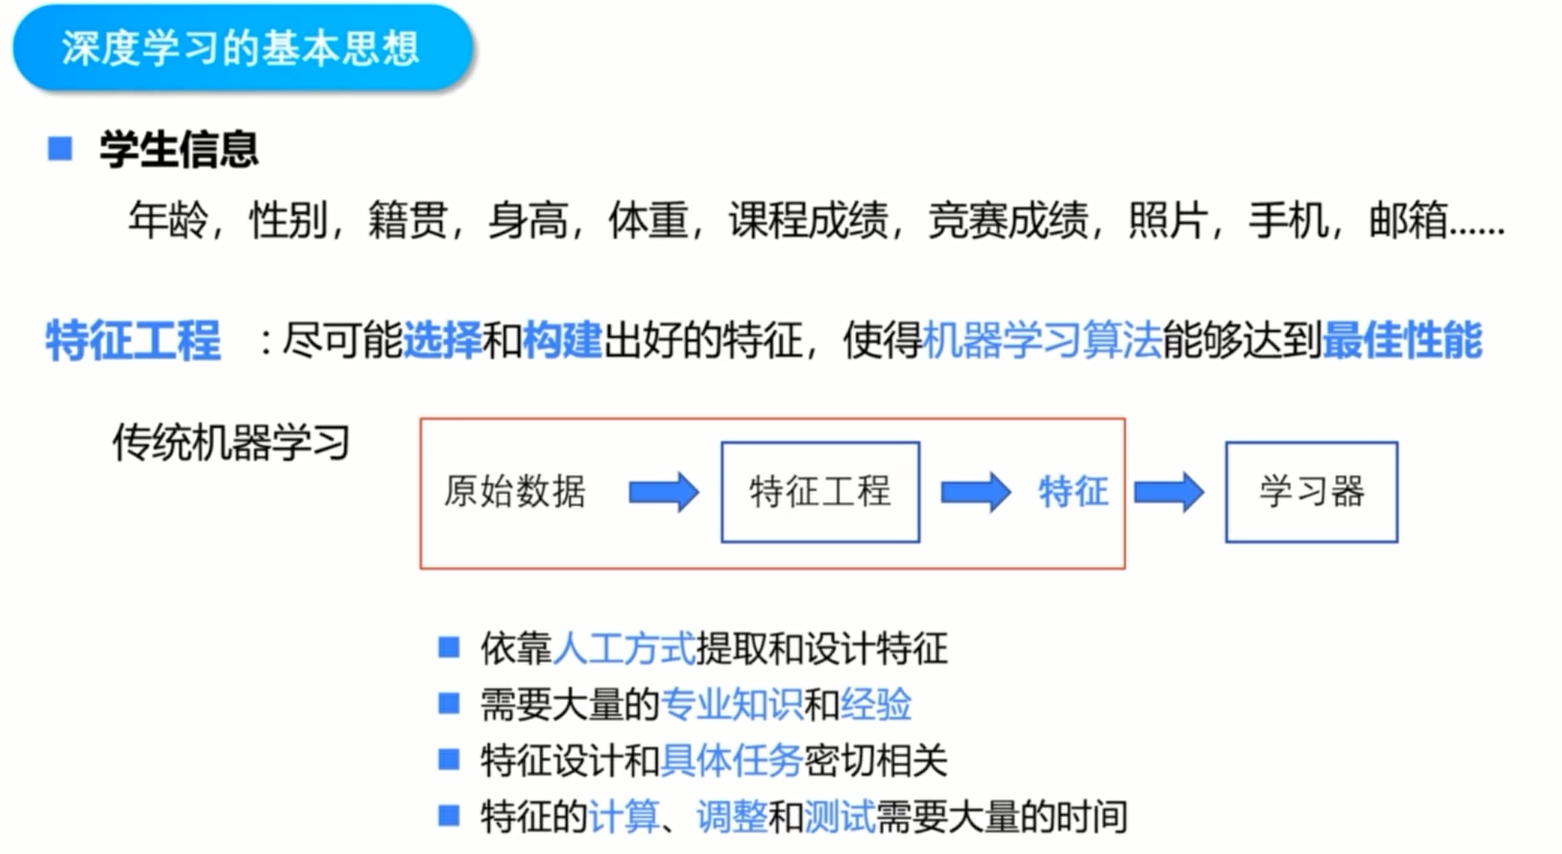
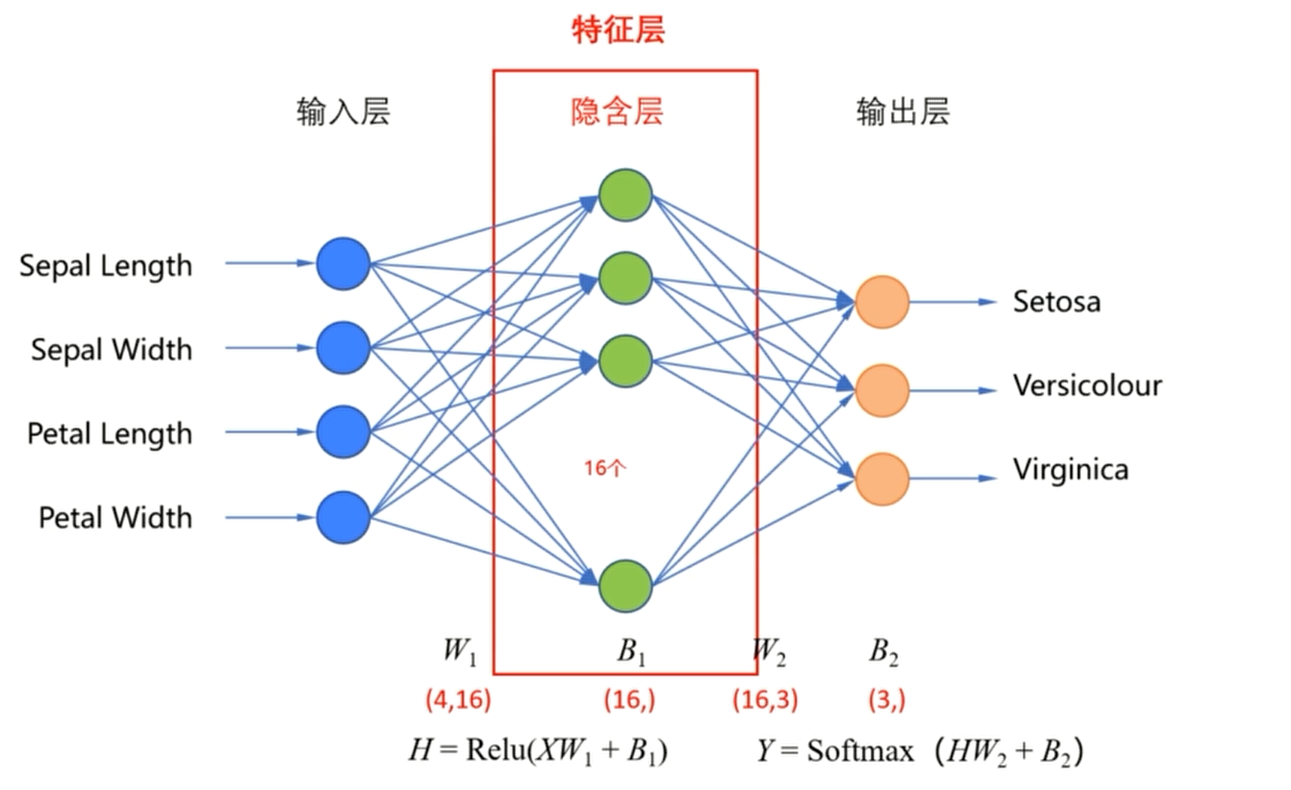
其实,在全连接神经网络中,隐含层的作用就是提取特征,每经过一层隐含层,都可以看作是一次特征转换。因此,神经网络的隐含层也被称为特征层。
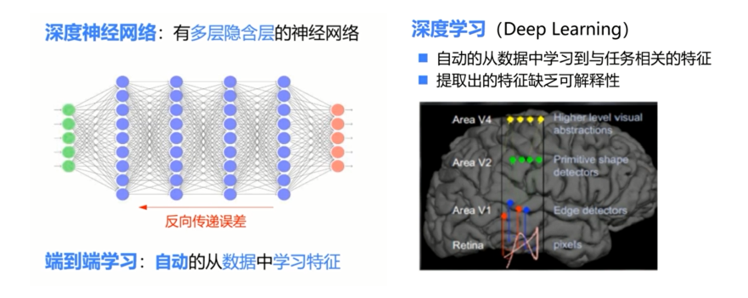
深层神经网络的隐含层不断对输入的低层特征进行组合,形成更加抽象的高层特征。最后,使用一个softmax分类器进行分类。其实,神经网络可以看作是一种自动提取特征的方法。使用神经网络,特征工程就没那么重要了,只需要对原始数据做一些必要的预处理之后,把它们直接喂入神经网络,通过训练,自动地调整权值。
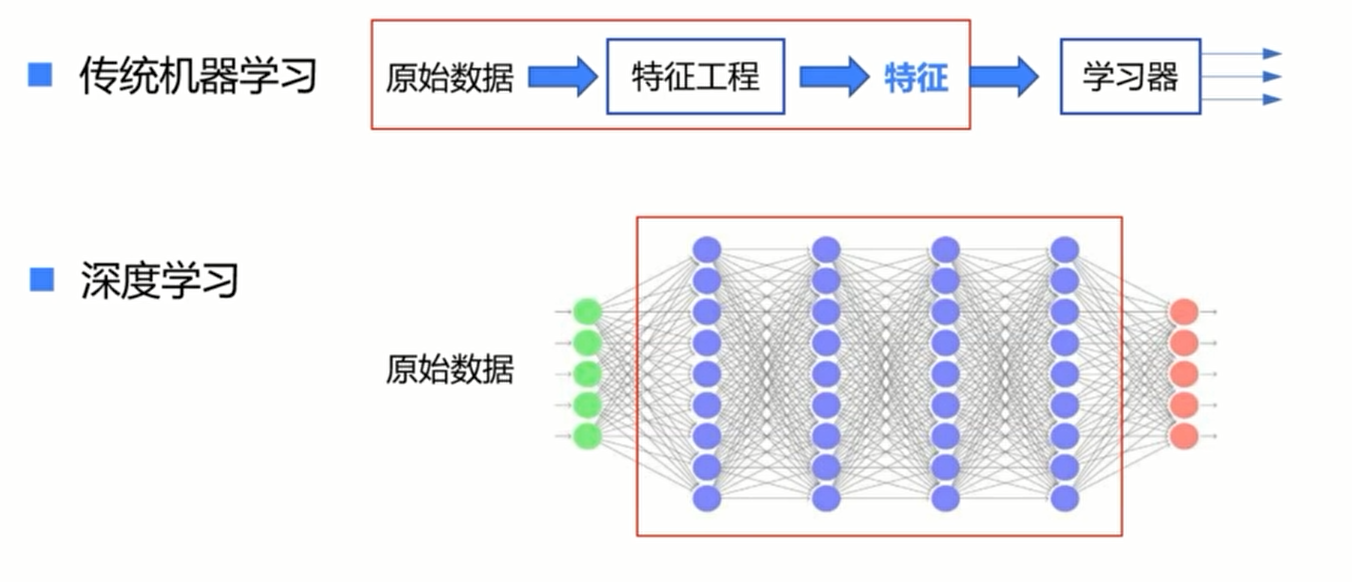
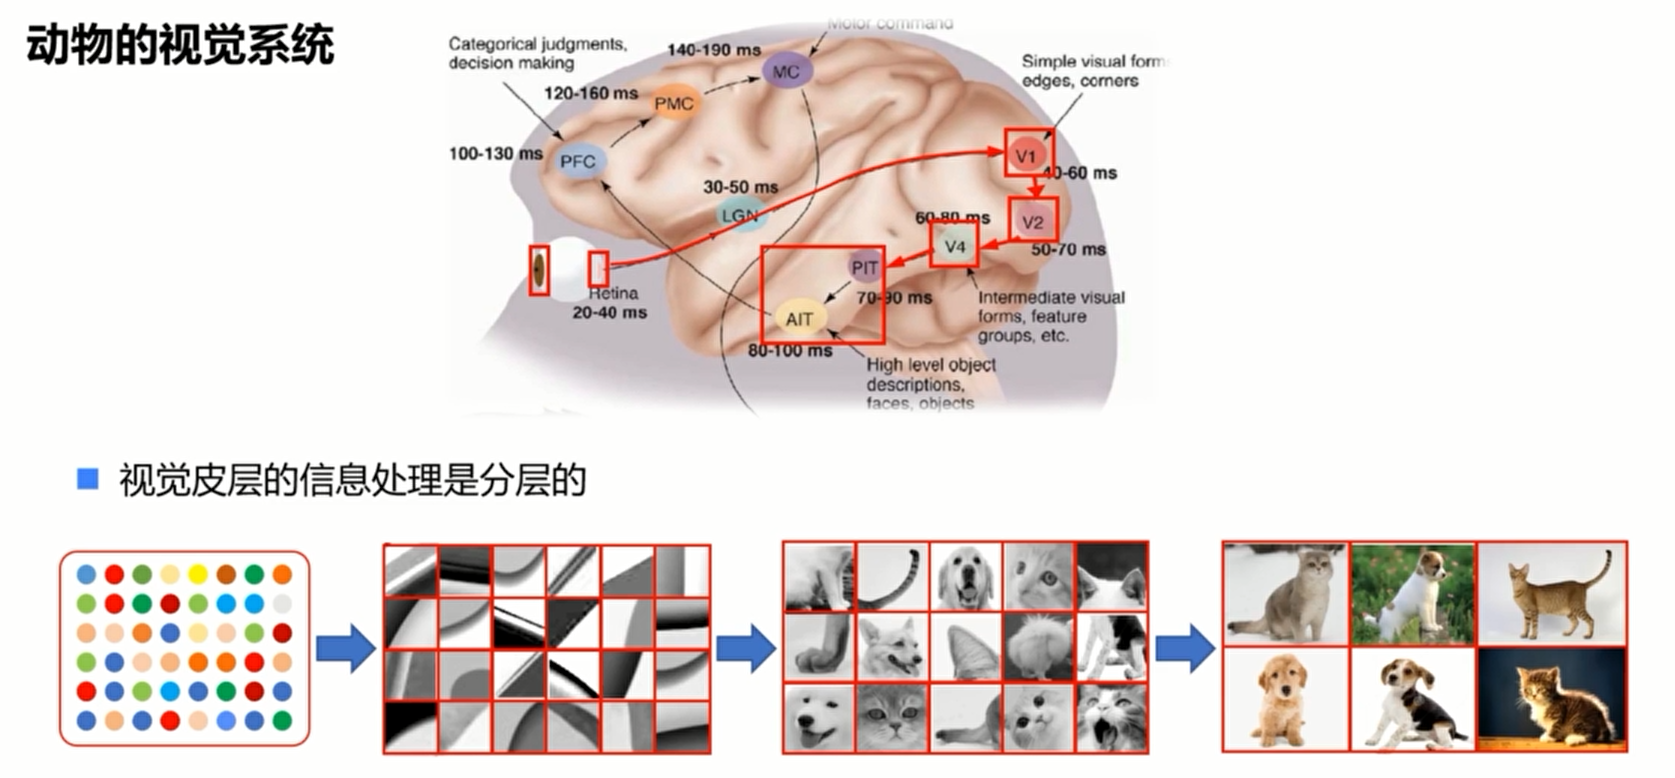
深度神经网络可以看作是对人脑分层机制的模仿,通过多层隐含层,不断组合低层特征,形成更加抽象的高层特征。神经网络中的隐含层越多,提取出的特征就更加抽象,表达能力也越好。
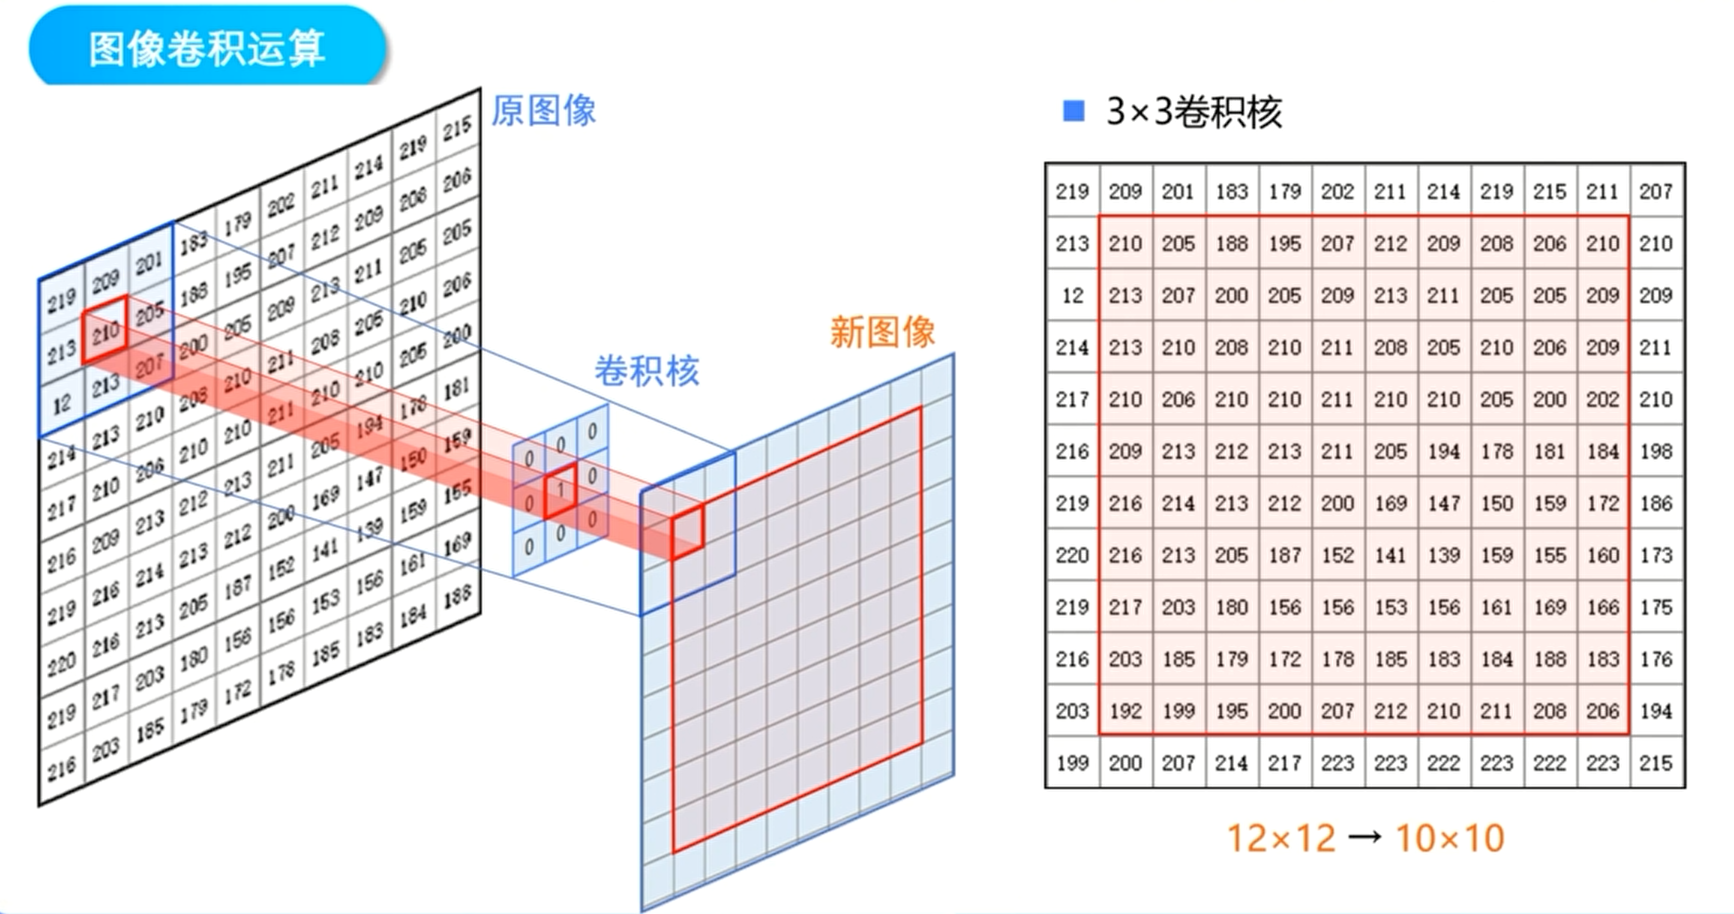
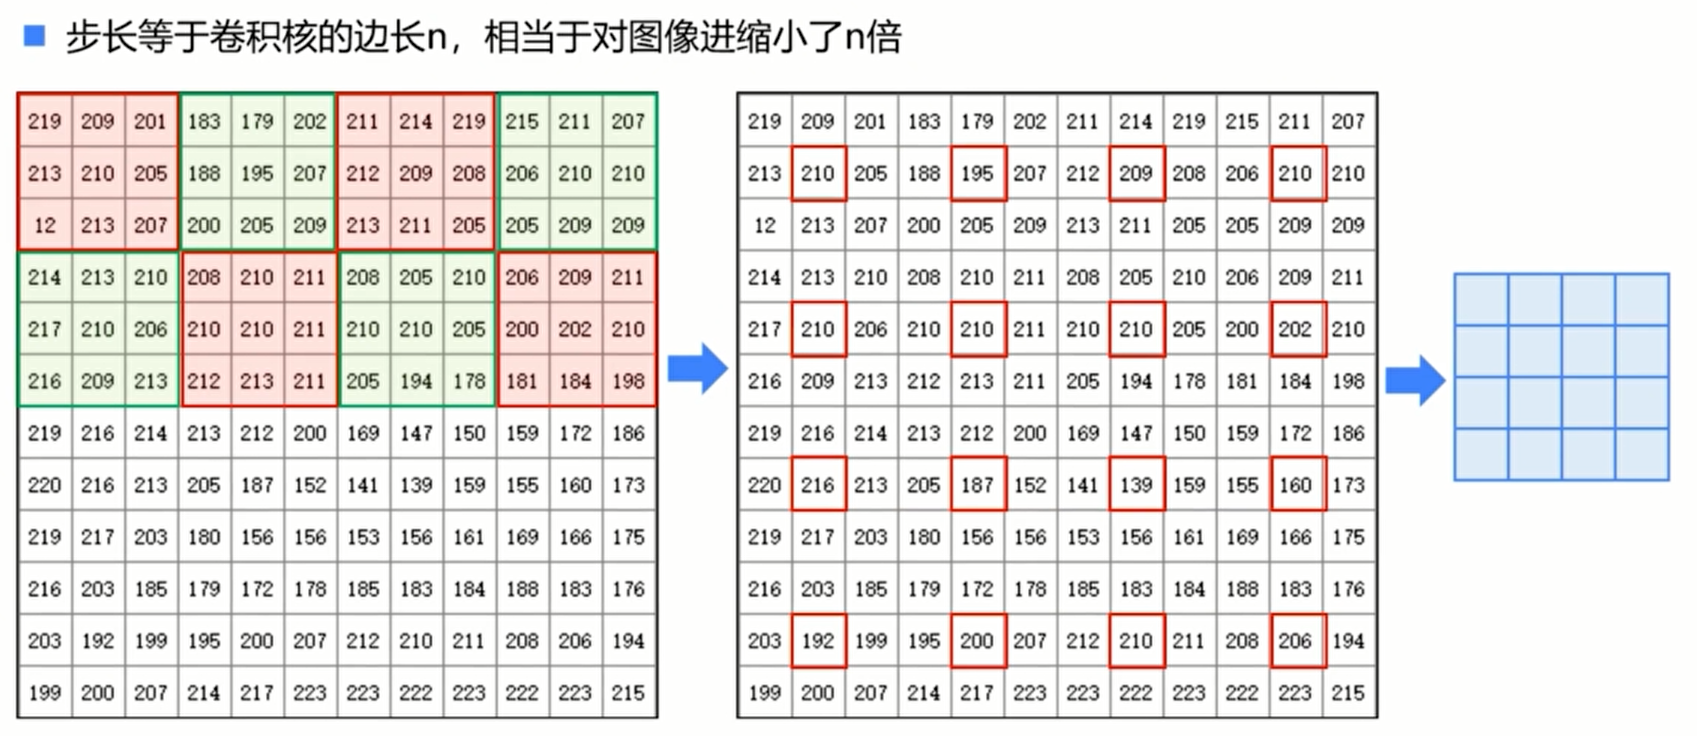
对数字图像做卷积运算,就是对图像中的每个像素点,用它周围像素点的灰度值,加权求和,去调整这个点的灰度值。
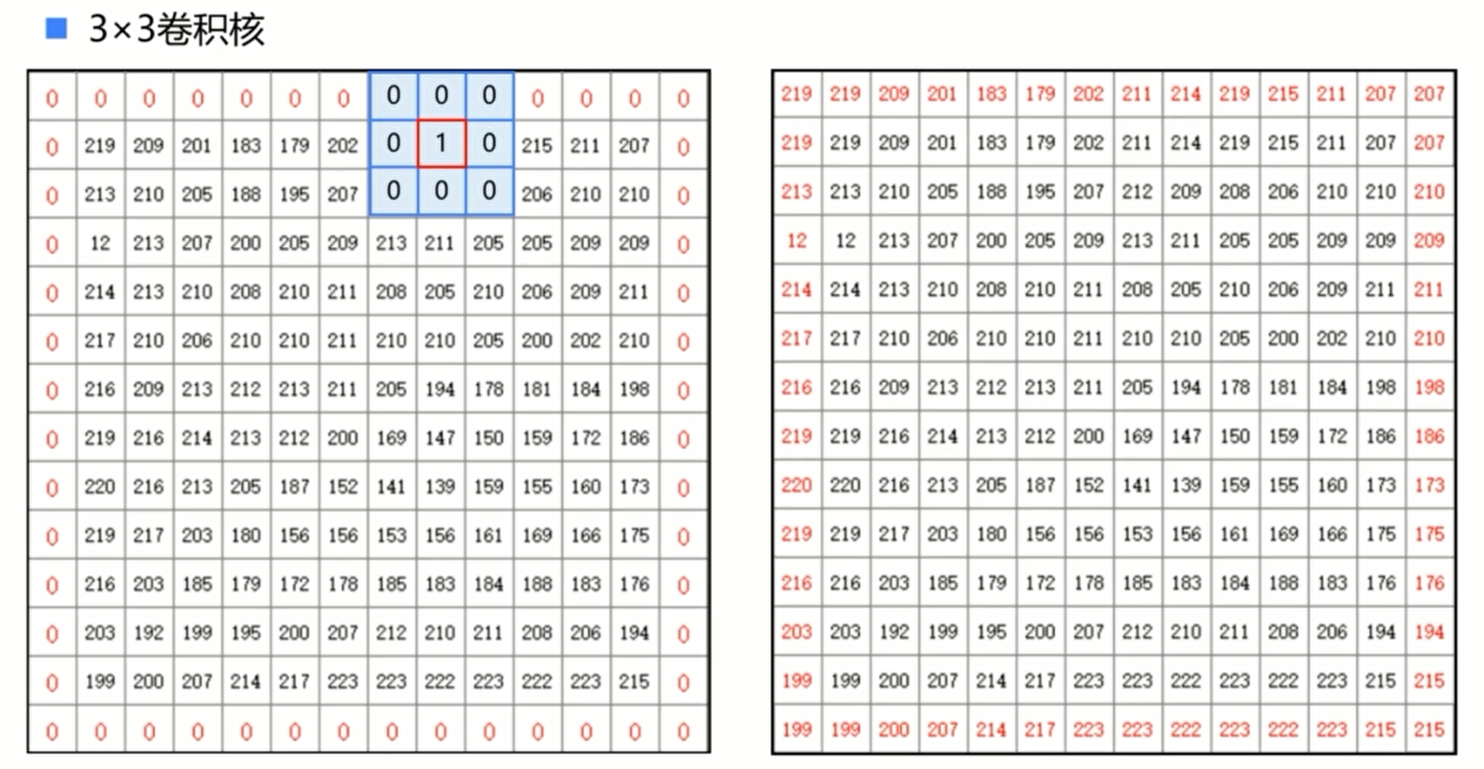
如果希望卷积运算得到的图像与原图的大小一样,可以在卷积运算之前,在图像周围填充一圈数字。这样就可以计算图像边界处的卷积。
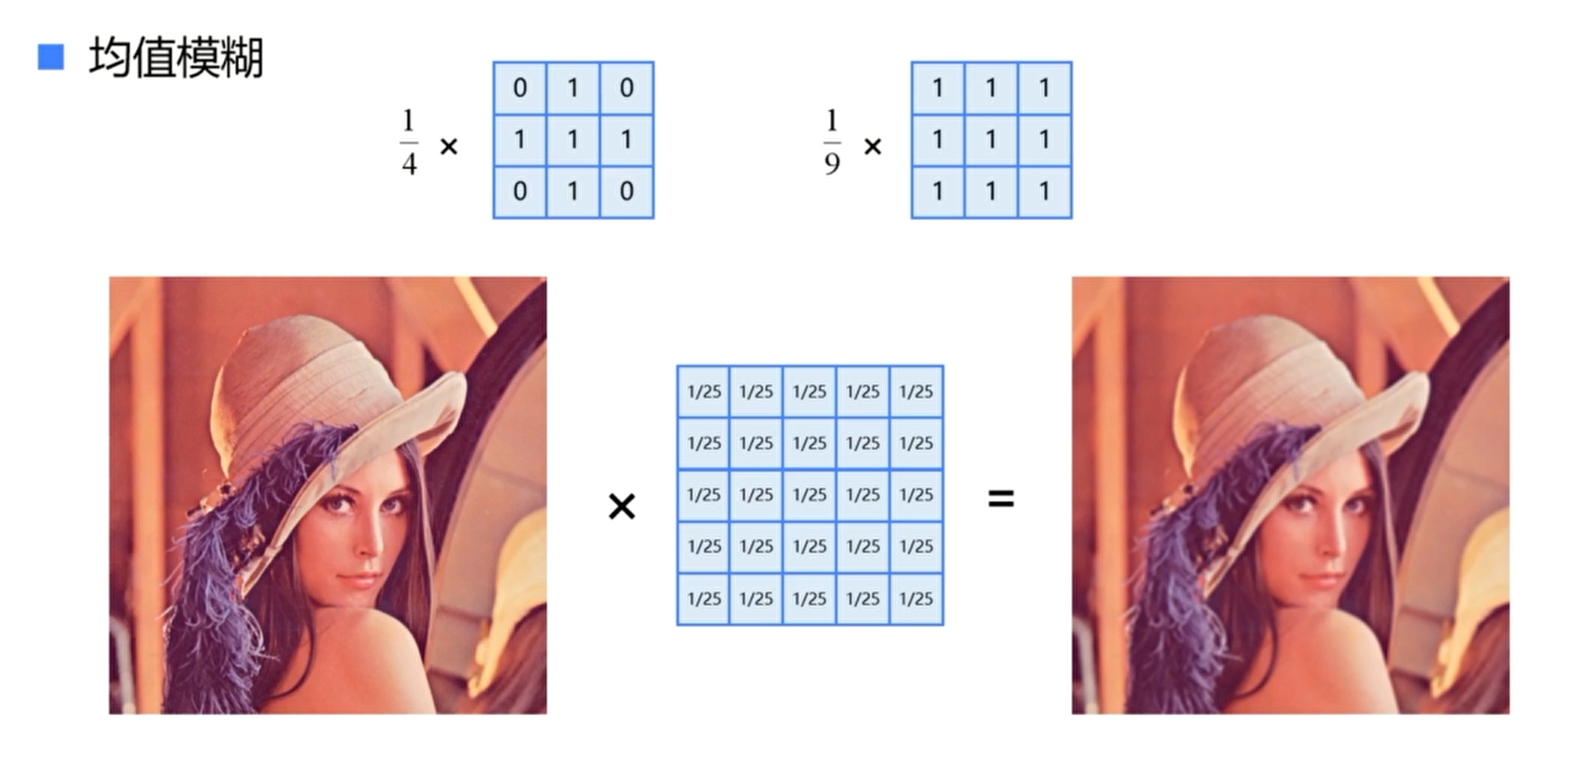
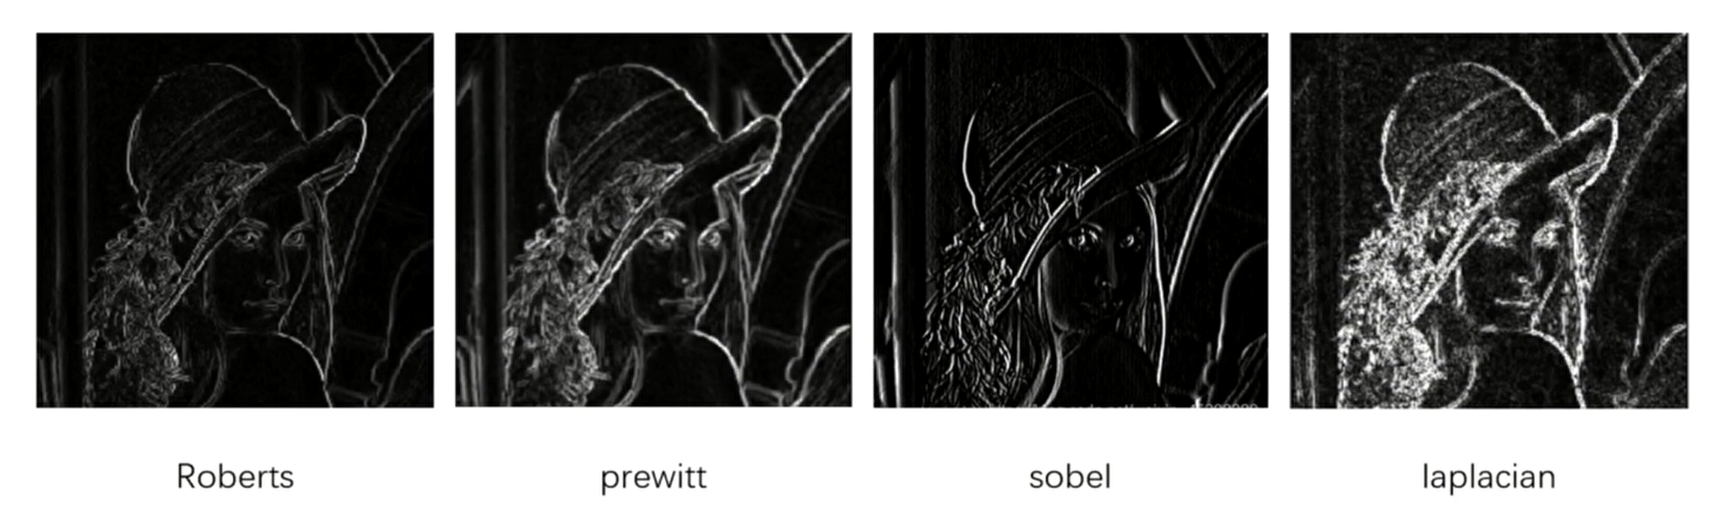
通过卷积运算,对图像进行模糊后,可以将图像中的高频噪声过滤掉,因此,对图像的卷积运算,也称为平滑或者滤波,卷积核也称为滤波器。
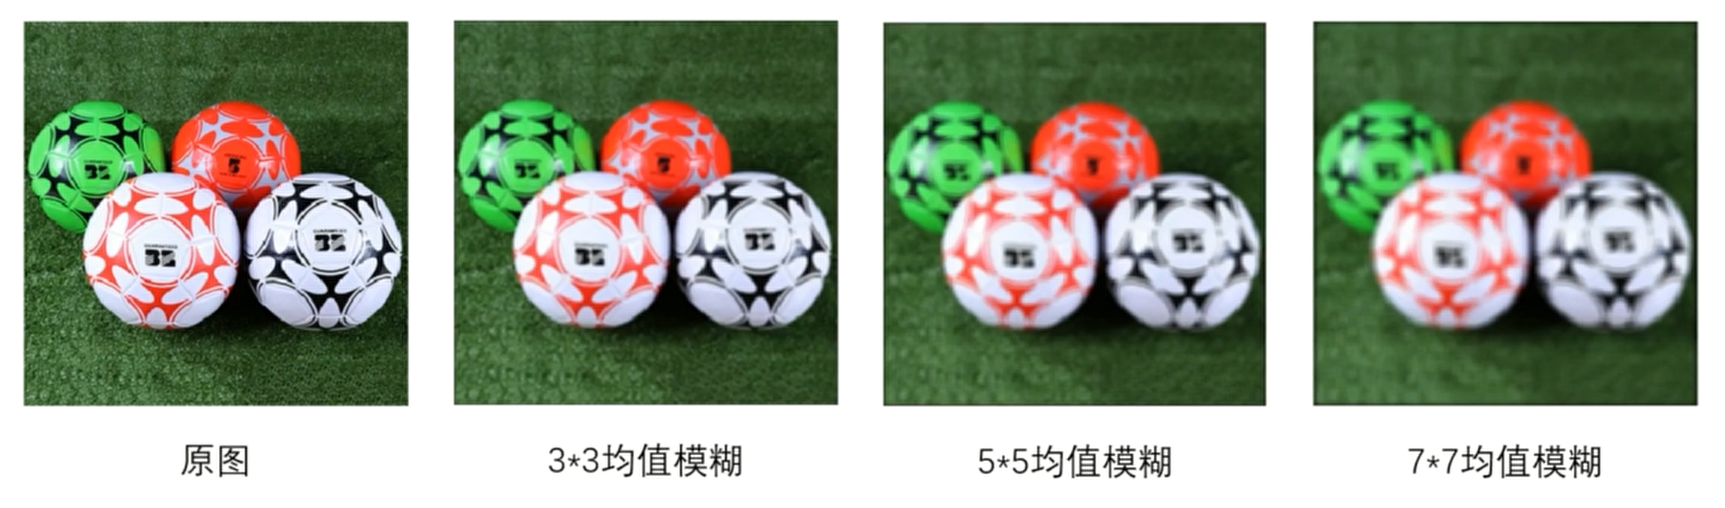
卷积核越大,图像越模糊。
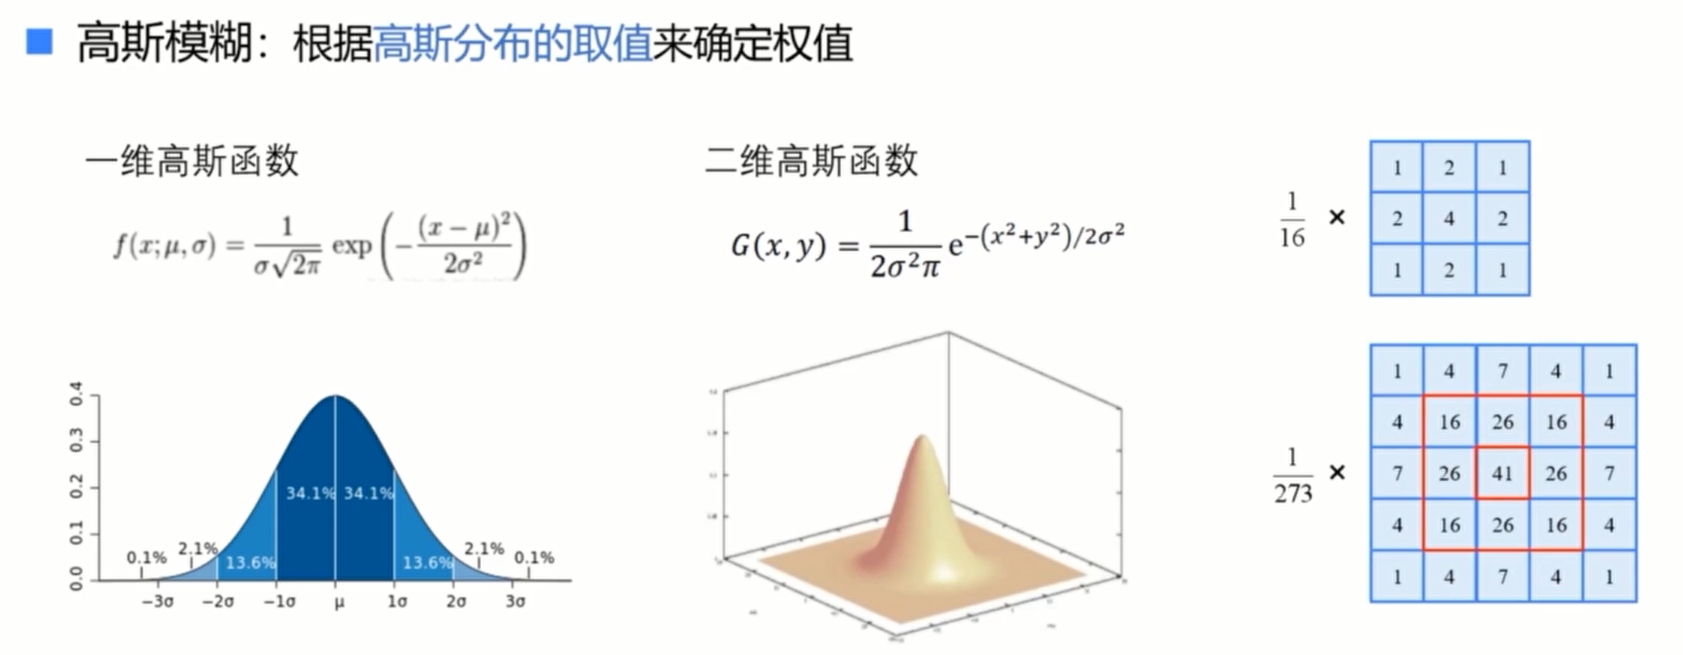
由于均值模糊是对窗口中的所有像素点求平均值,在图像的边缘胡纹理丰富的地方,也会变得模糊。为了尽可能地保留图像中的边缘信息,可以给不同位置的像素点赋予不同的权值。离中心点越近的像素,权值越大。
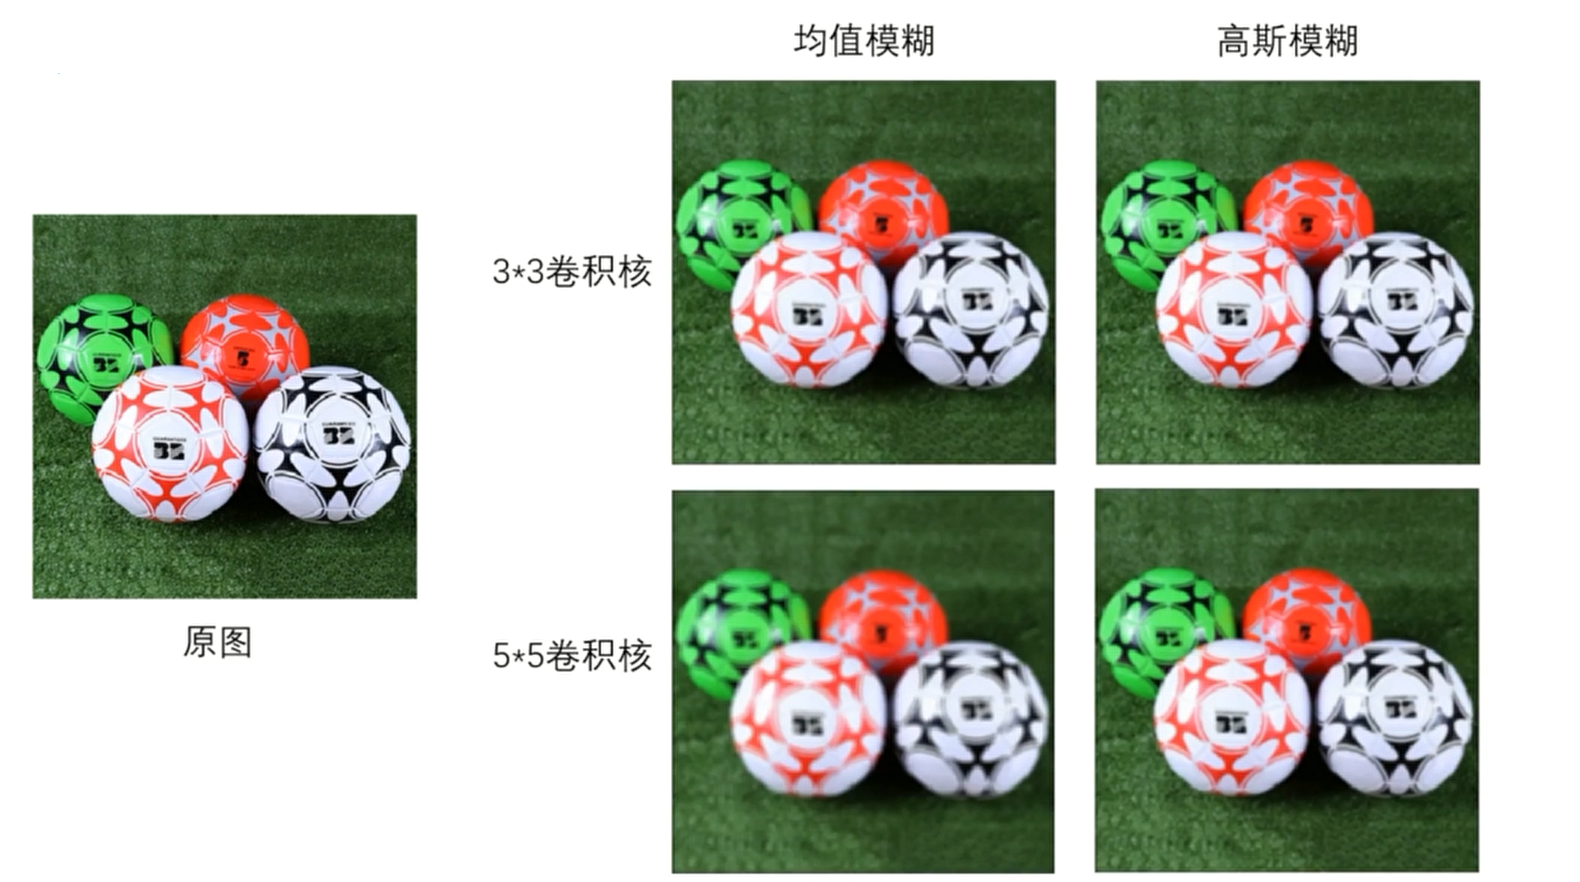
高斯模糊在平滑物体表面的同时,能够更好地保持图像的边缘和轮廓。
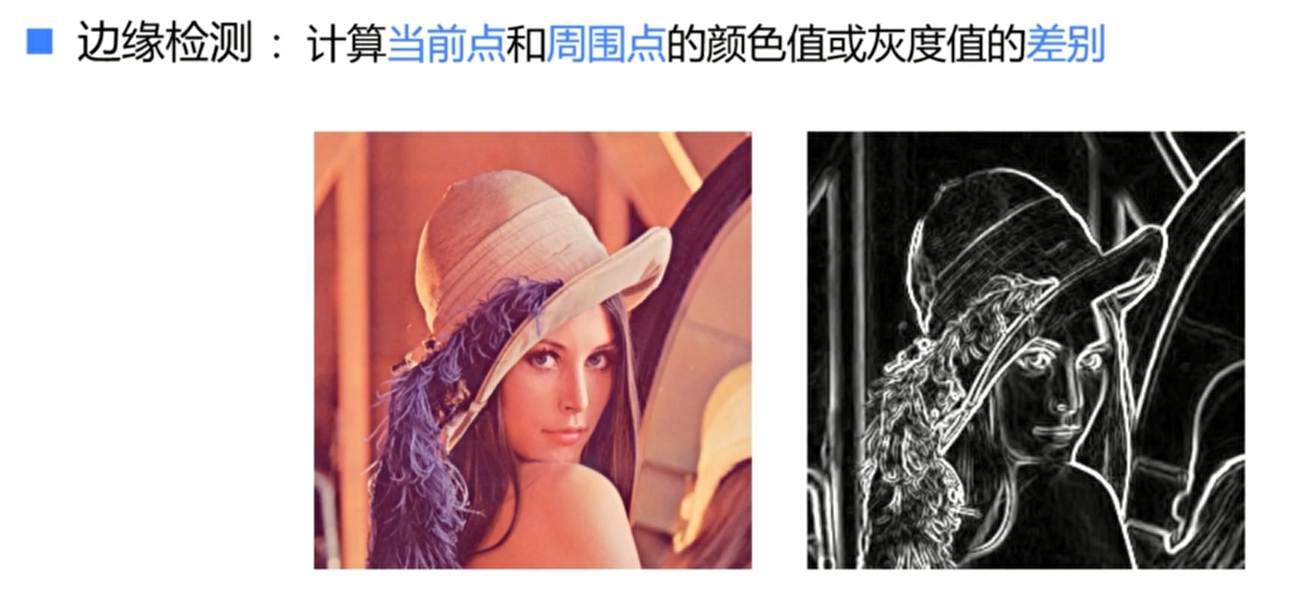
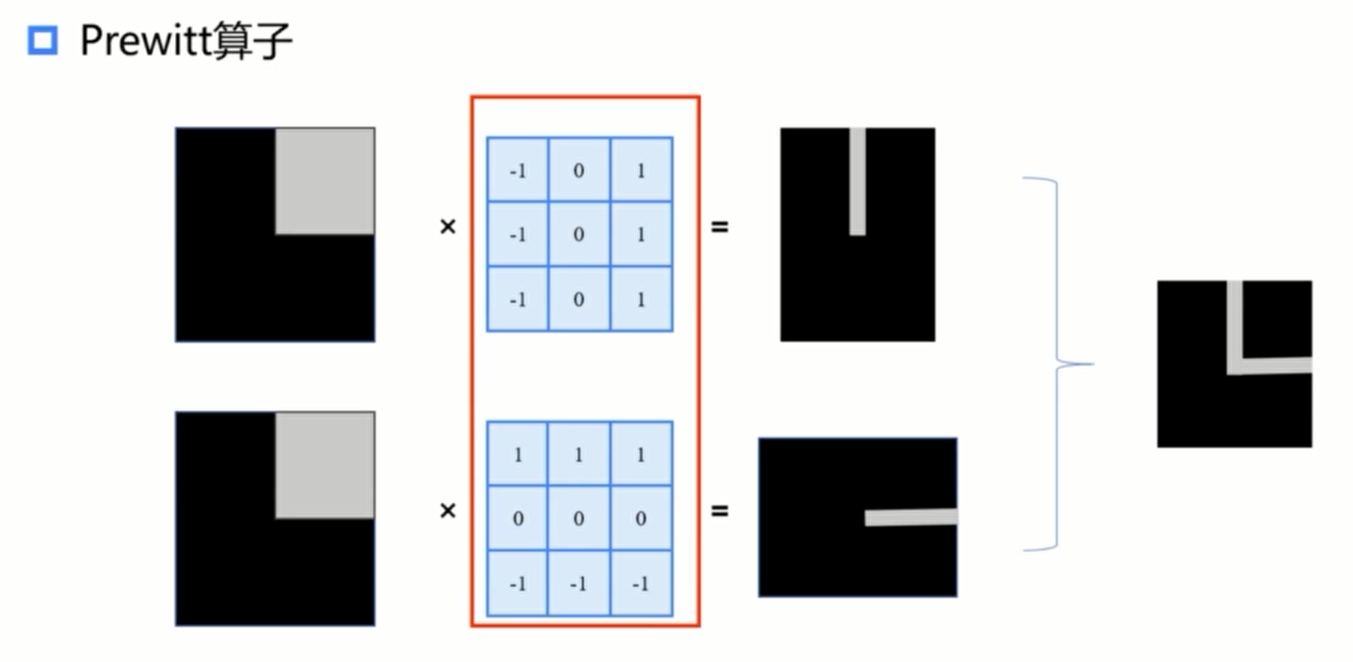
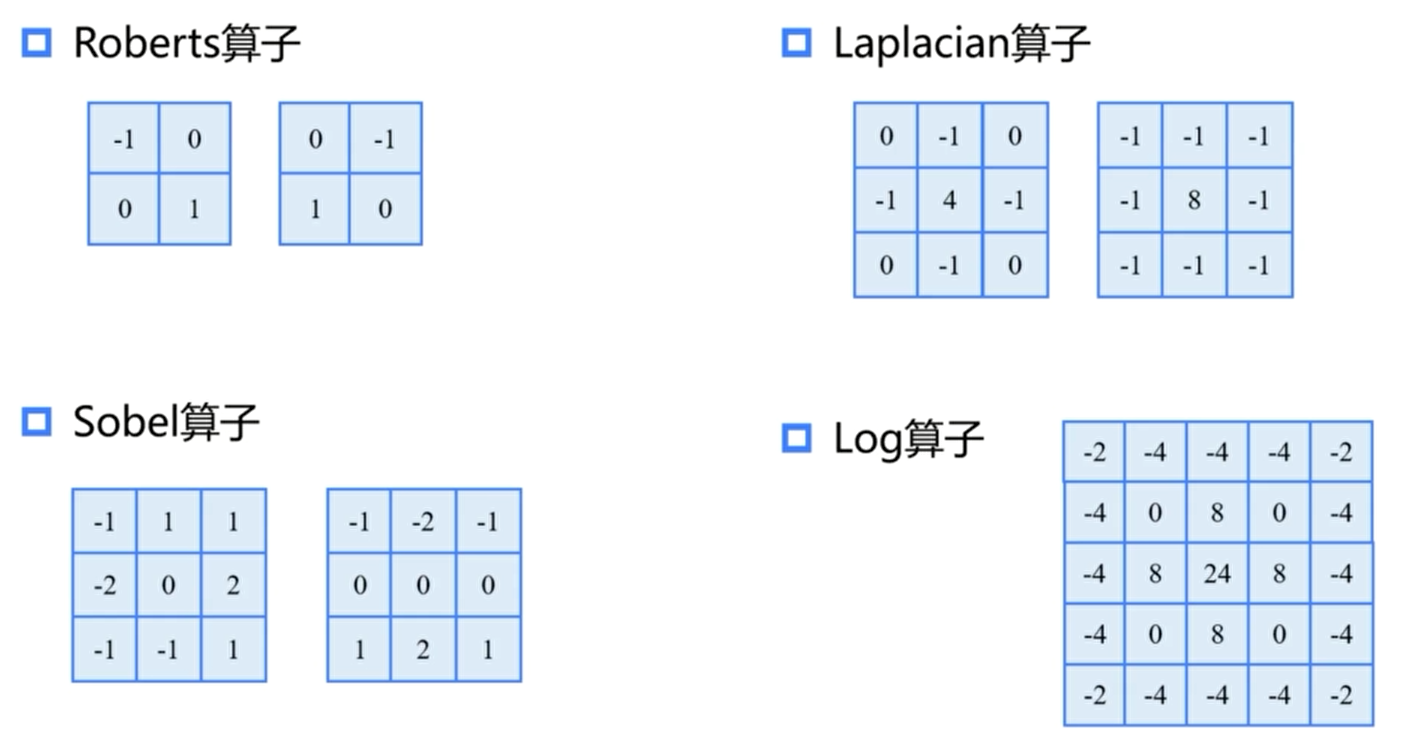
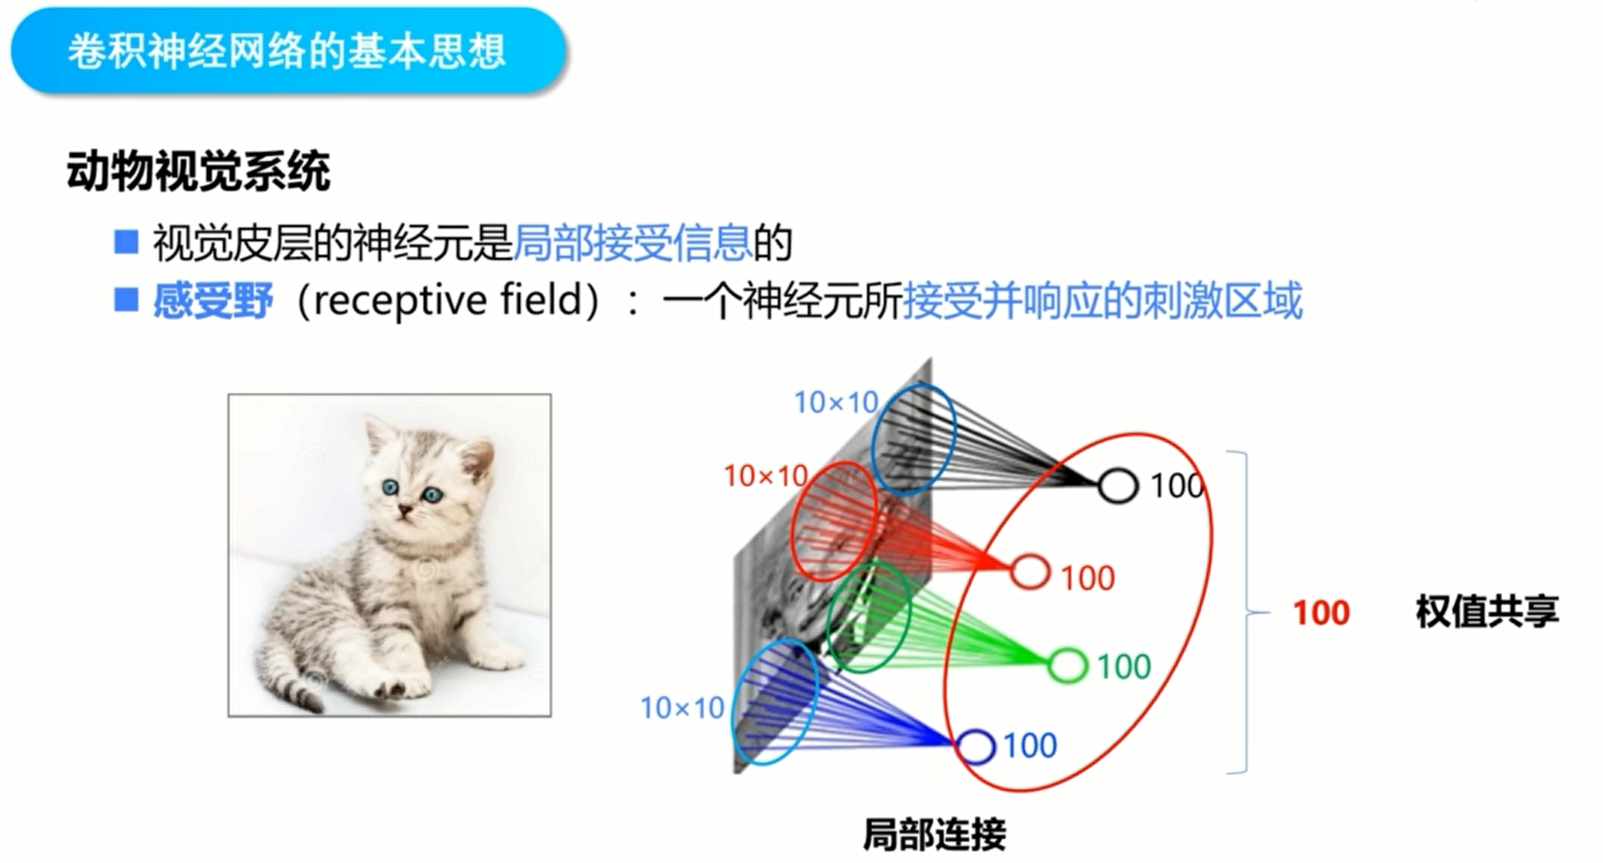
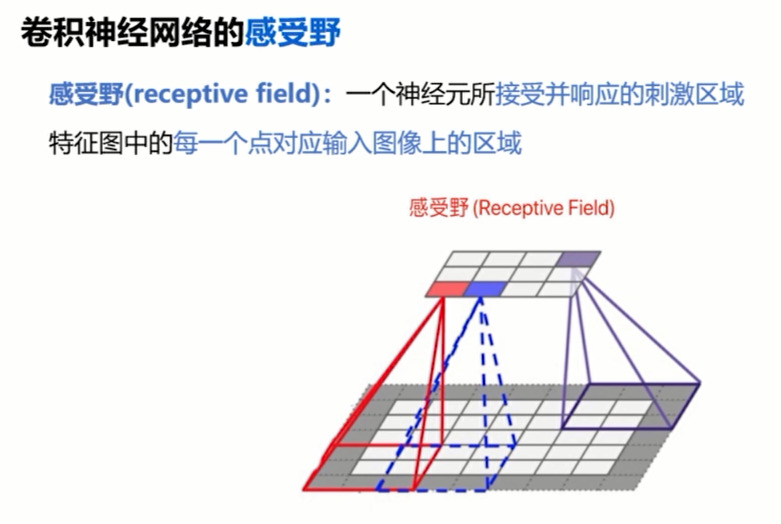
受感受野的启发,在图像中,距离相近的像素,联系较为紧密,而距离远的像素之间,相关性较弱。因此,隐含层中的神经元,不用接受输入图片中的每一个像素值,而只需要对局部区域进行感知。然后在更高层将这些局部的信息综合起来,就可以得到全局的信息。例如,隐含层中的每个神经元,只和输入层中的一个10*10的小区域链接,这种方式称为局部链接。同时,为了进一步减少参数数量,规定隐含层中的所有神经元,共享同一组参数,称此为权值共享。
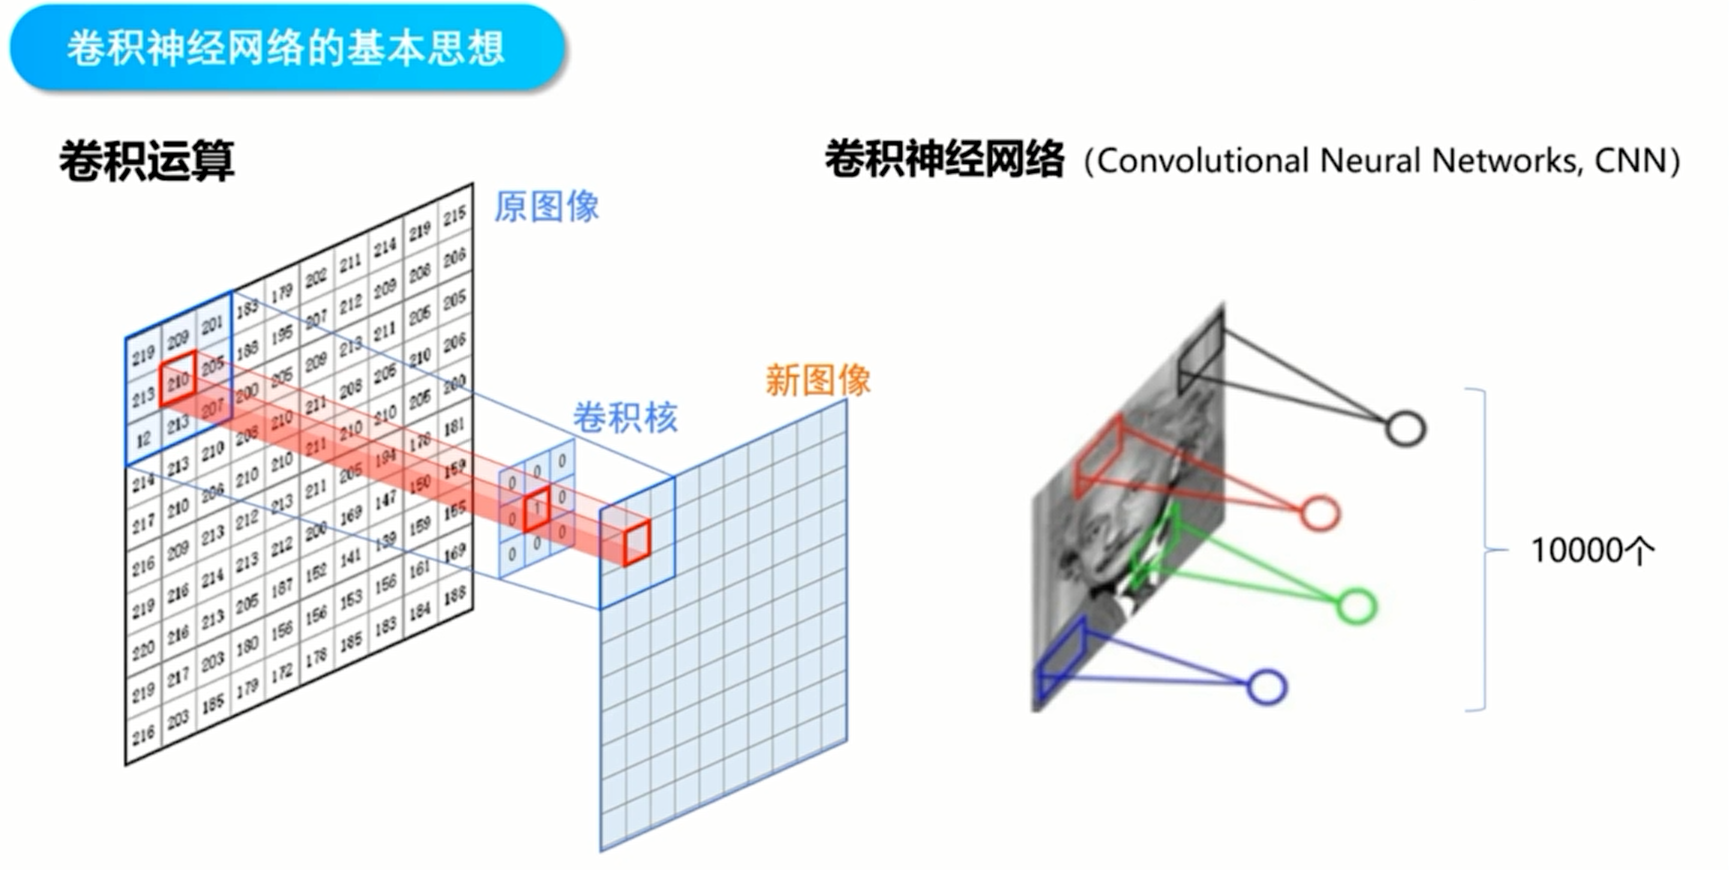
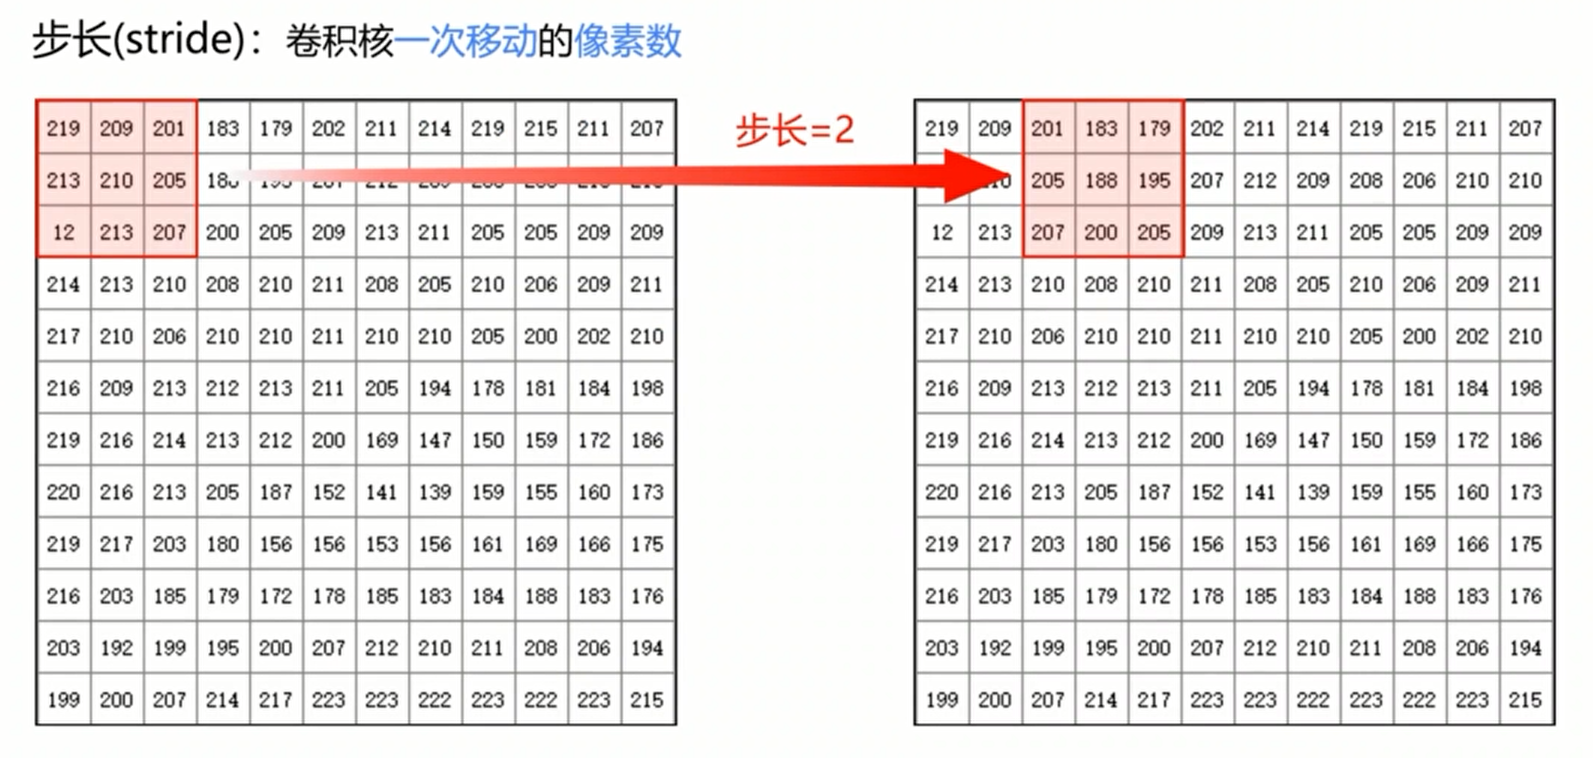
当隐含层中的感受野范围相同,权值也都相同,也就相当于使用同一个卷积核,在整个图像上滑动,做卷积运算,这100个权值共同构成了一个卷积核。这种网络被称为卷积神经网络。
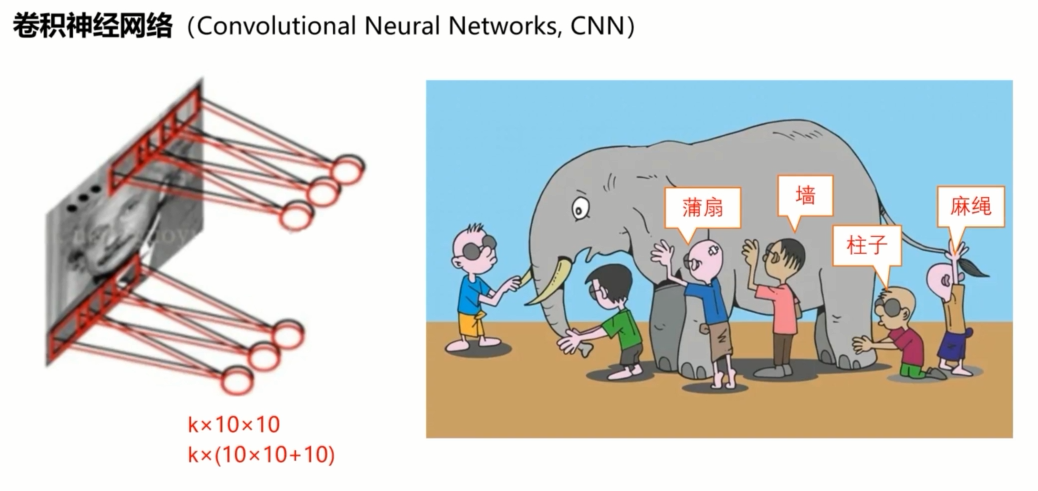
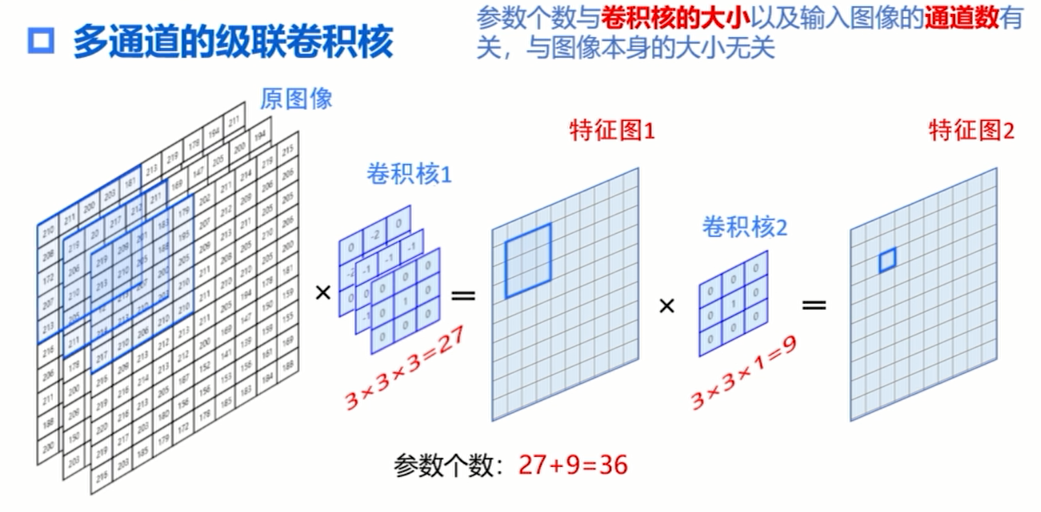
一个卷积和只能提取一种特征,如果想要提取多种不同的特征,可以同时使用多个卷积核。当图像时,需要对RGB三个通道分别做卷积操作。
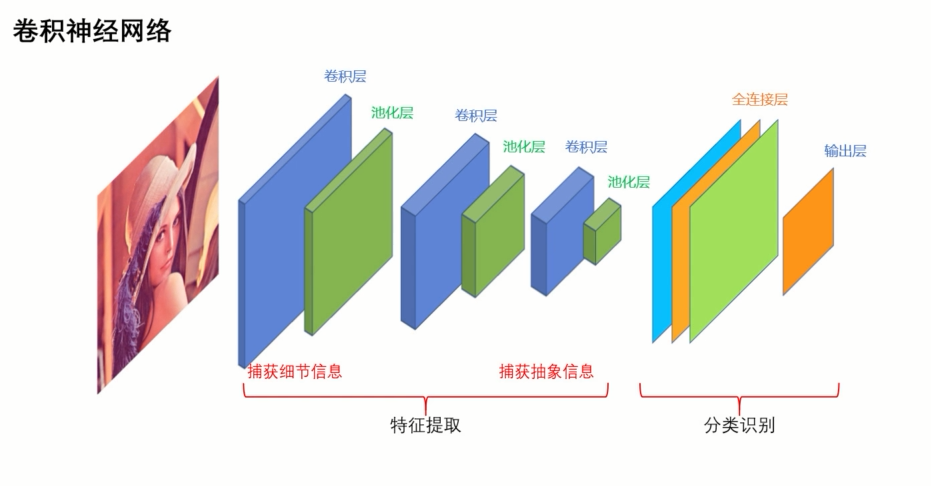
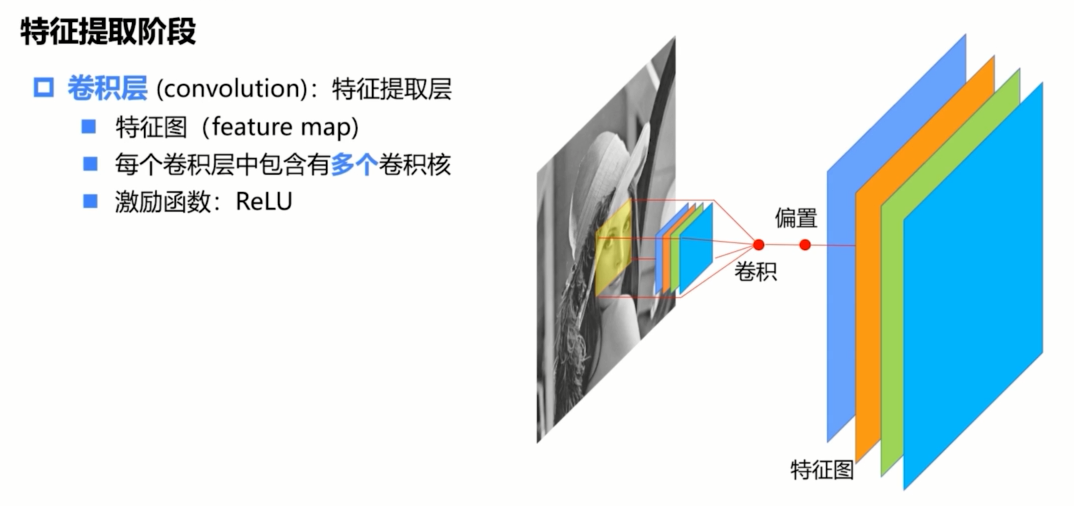
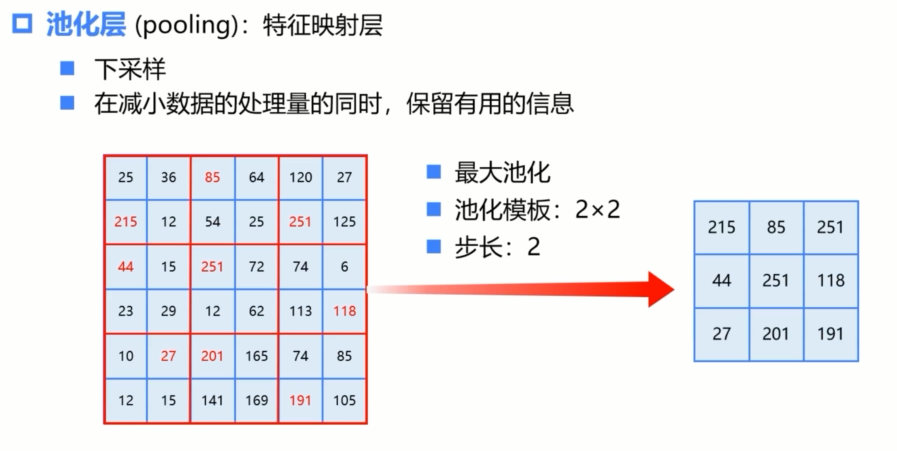
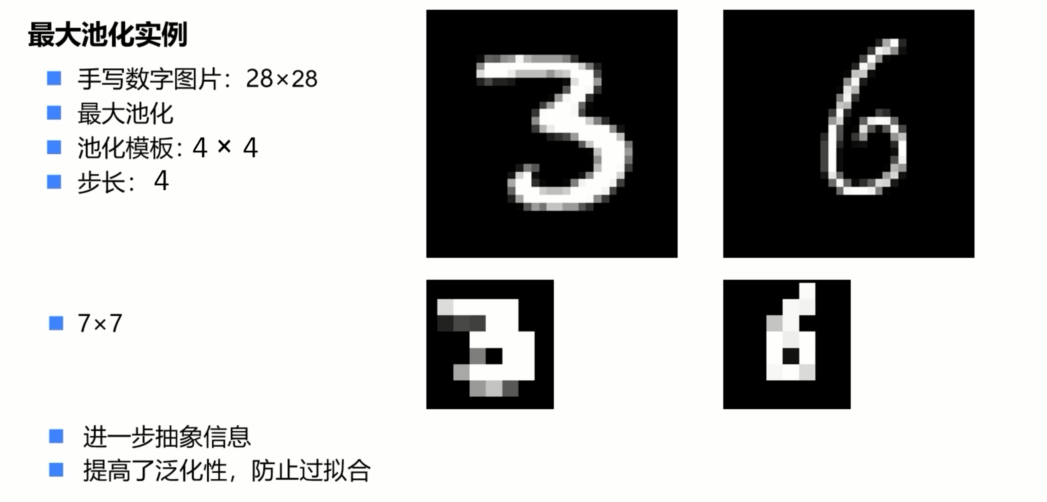
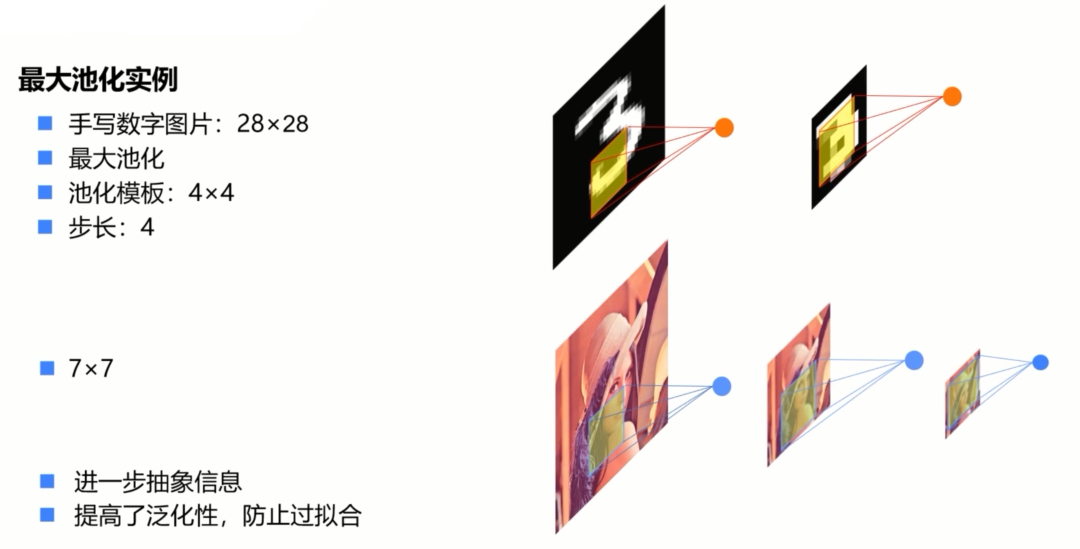
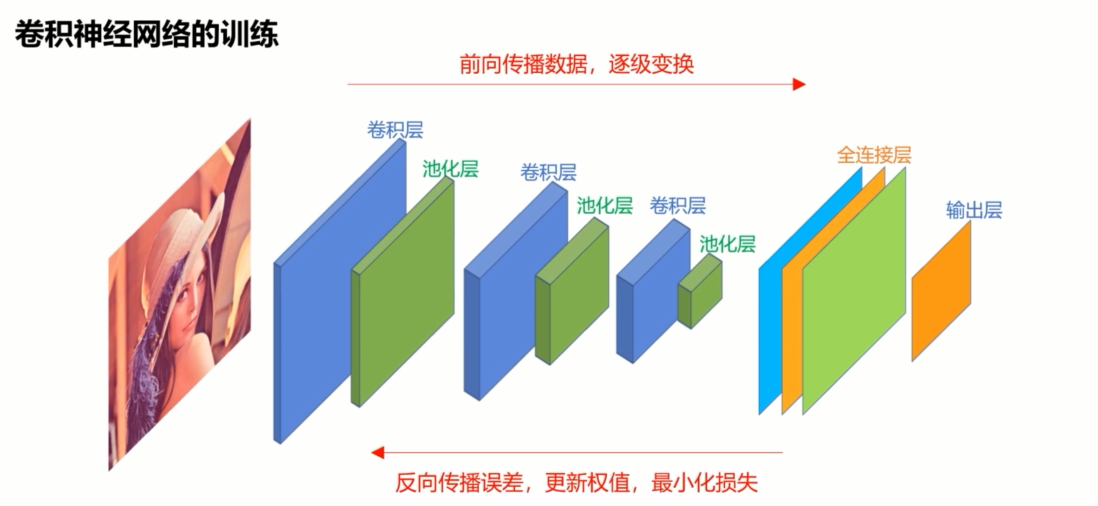
在网络前端的卷积层中,每个神经元只连接输入图像中很小的一个范围,感受野比较小,能够捕获图像中局部细节的信息,而经过多层卷积层和池化层的堆叠后,后面的卷积层中,神经元的感受野逐层加大,可以捕获图像中更高层,更抽象的信息,从而得到图像在各个不同尺度上的抽象表示。
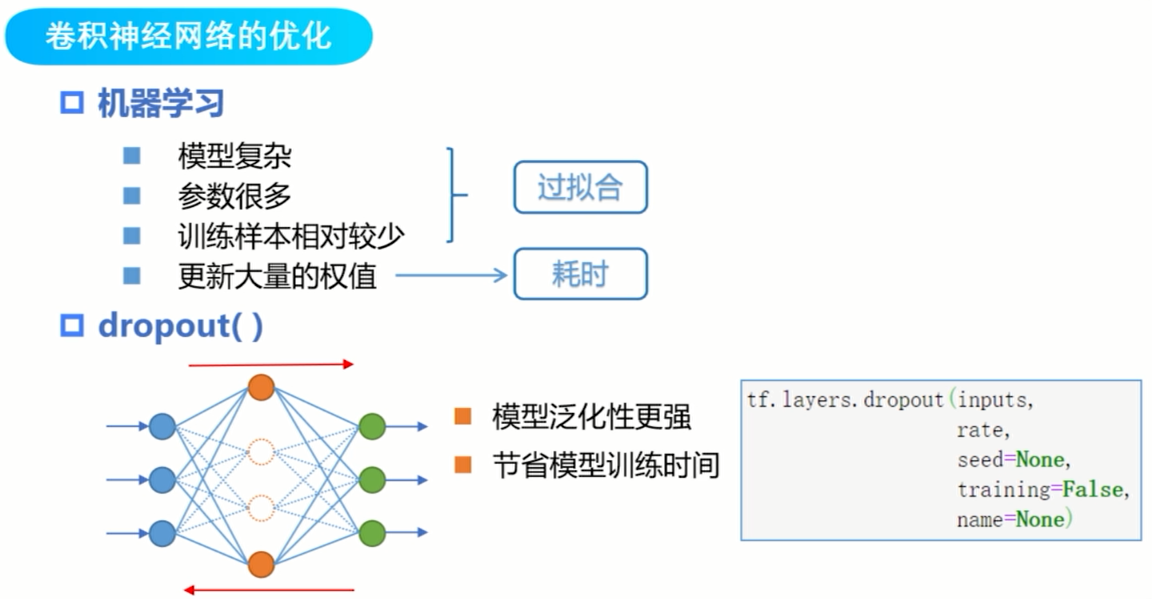
为了防止过拟合,在训练复杂的前馈型神经网络时,可以加入dropout操作。在训练时,随机让神经网络的某些隐含层节点停止工作,也就是让它们的权值为零,就好像从网络中删除了这些节点一样。使用dropout后,可以使得对某些局部特征的依赖减小,提高模型的泛化性。同时,由于dropout减少了部分更新权值的时间,从而大大节省了模型训练的时间。
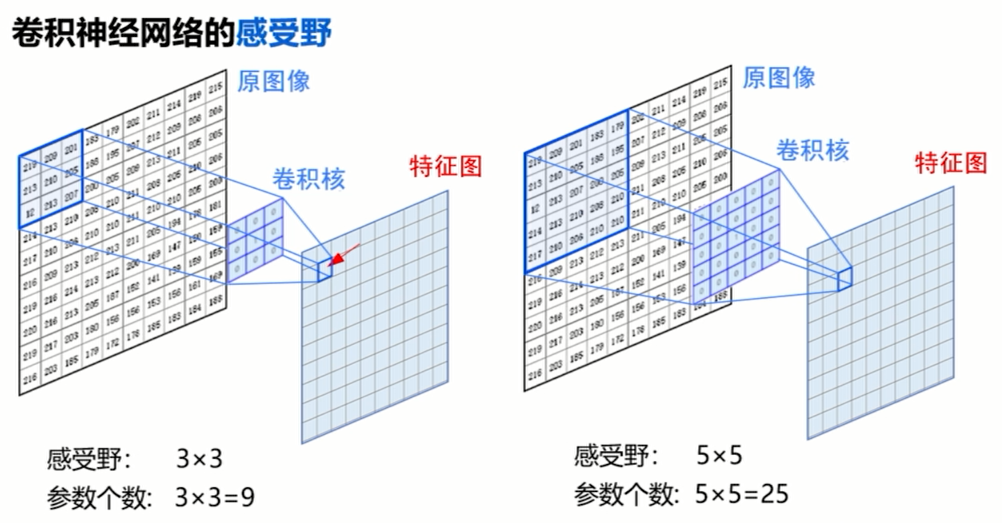
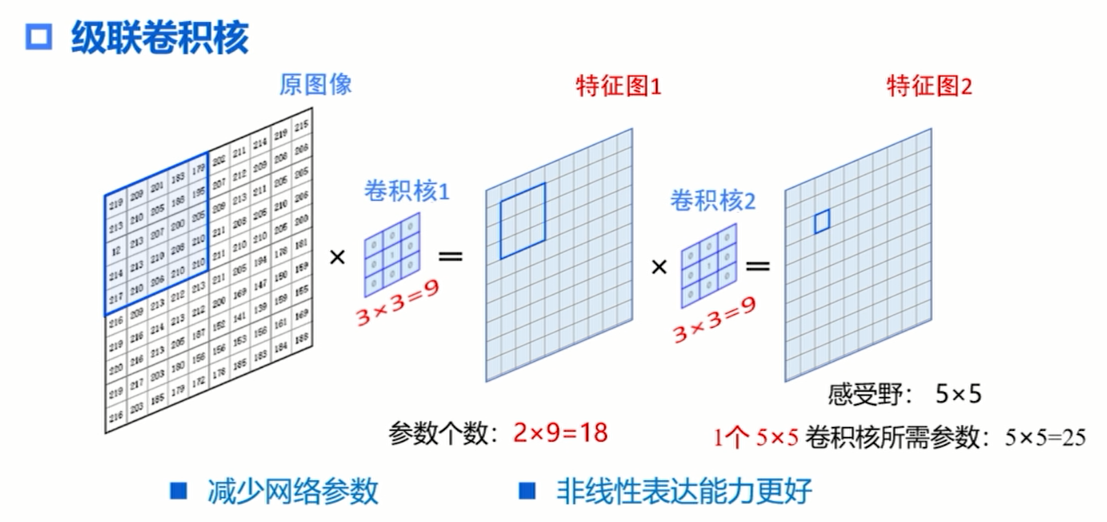
使用两个33的卷积核和使用一个55的卷积核,可以得到同样大小的感受野。而使用两个33的卷积核参数个数小于一个55的卷积核。堆叠多个小的卷积核代替大的卷积核,不仅参数更少,而且卷积层数越多,特征提取就越细致,加入的非线性变换也越多,可以使得模型的非线性表达能力更好。
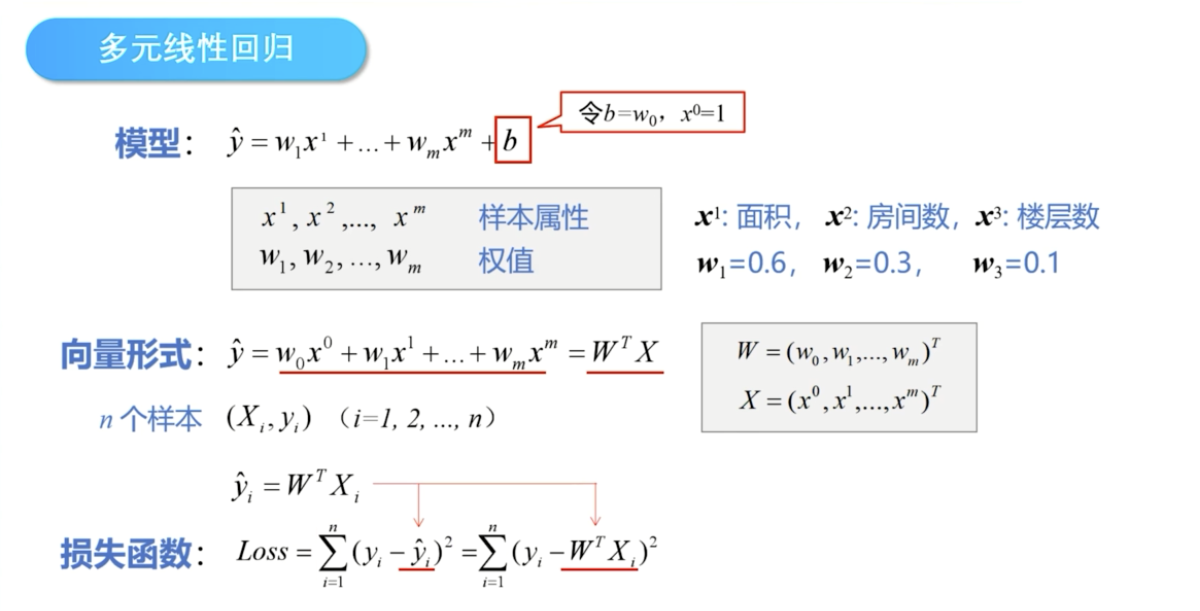
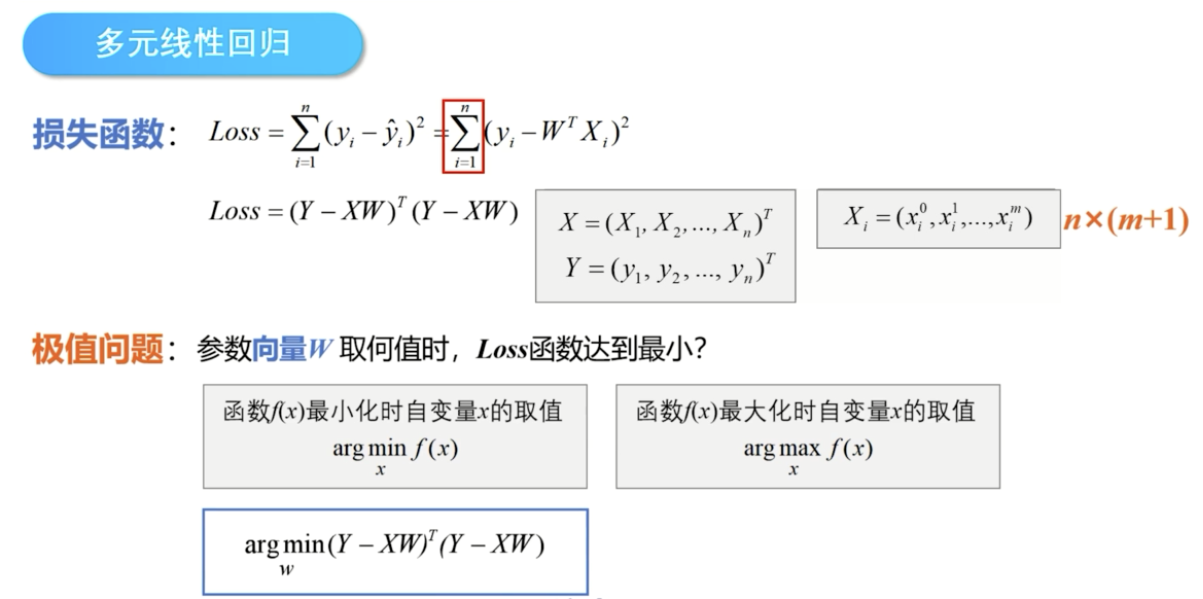
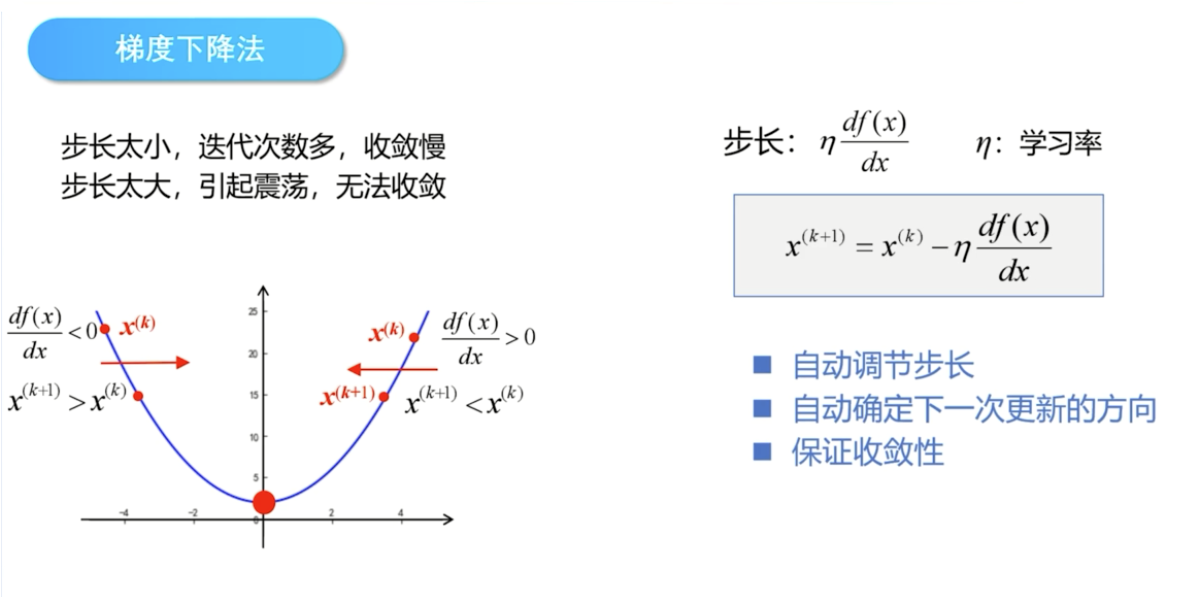
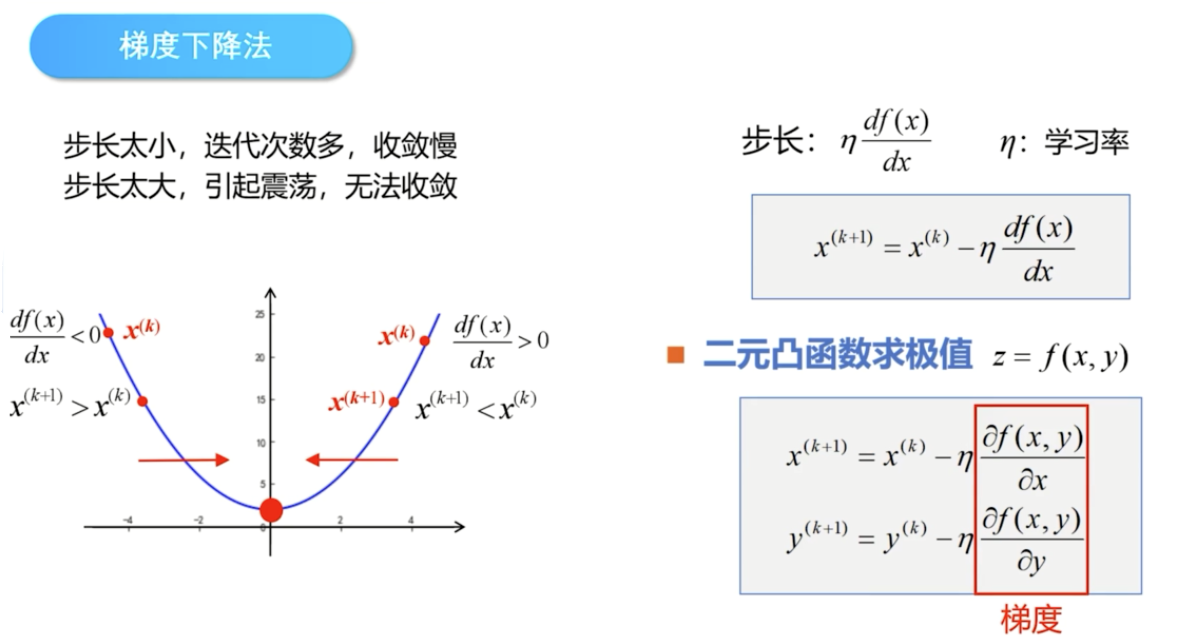
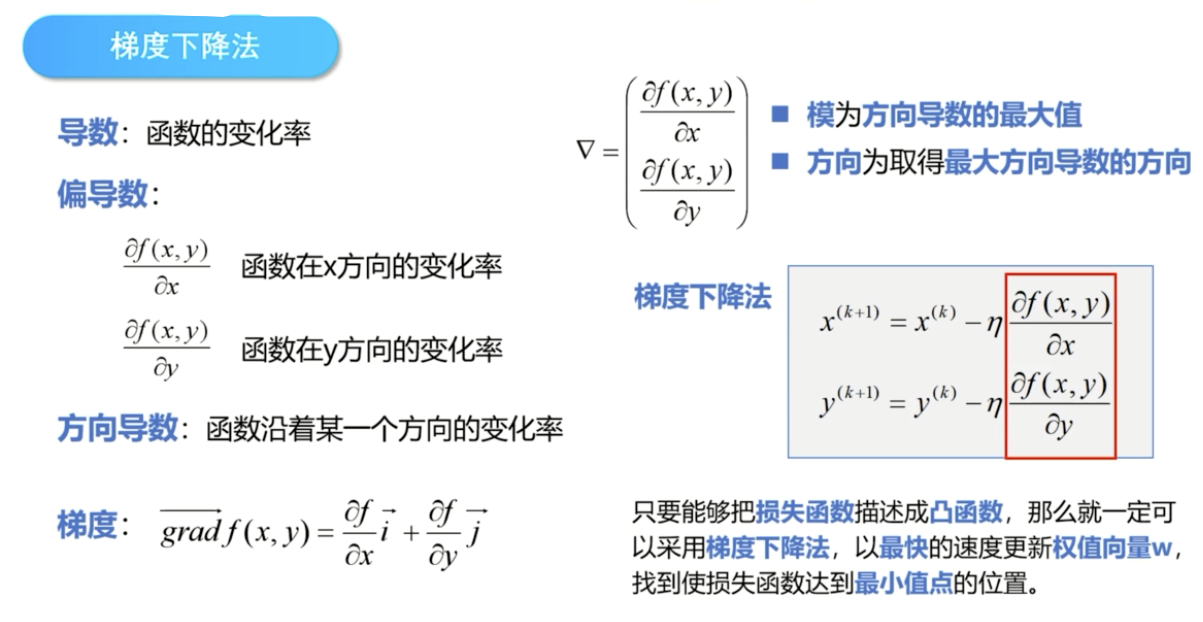
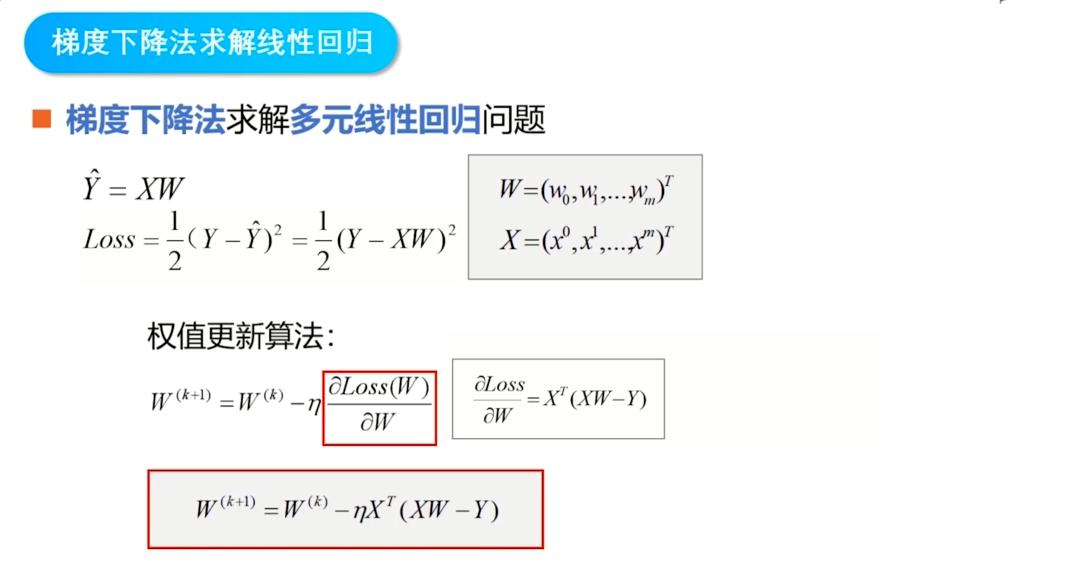
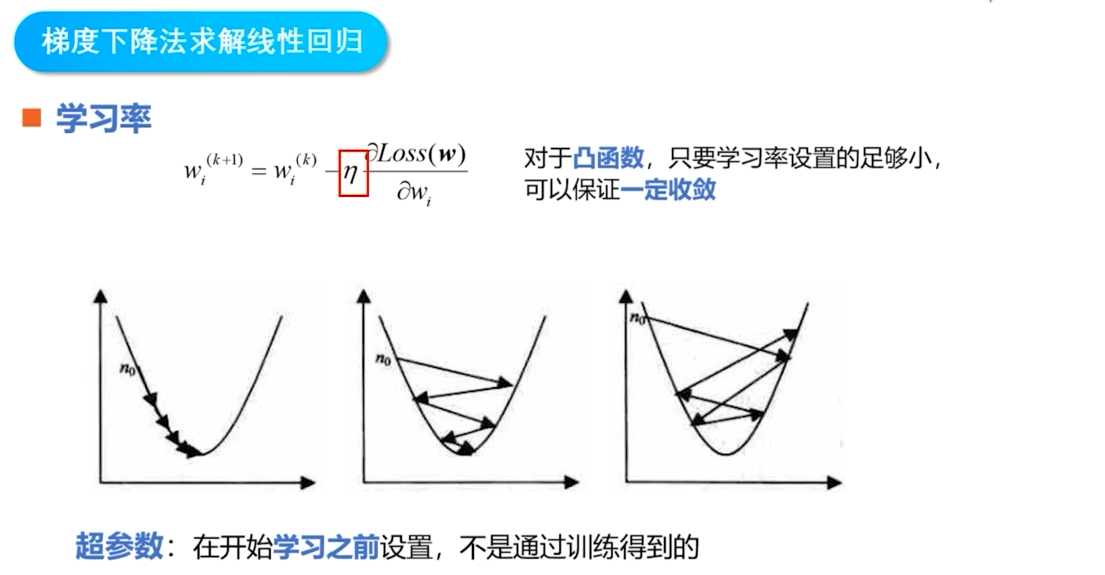
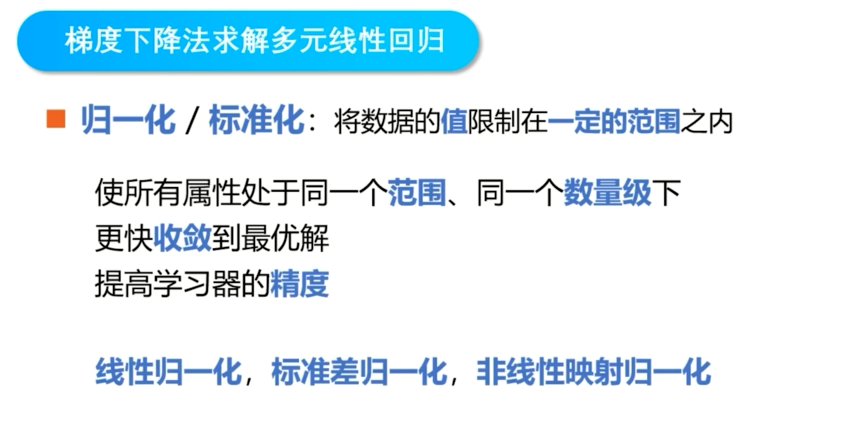
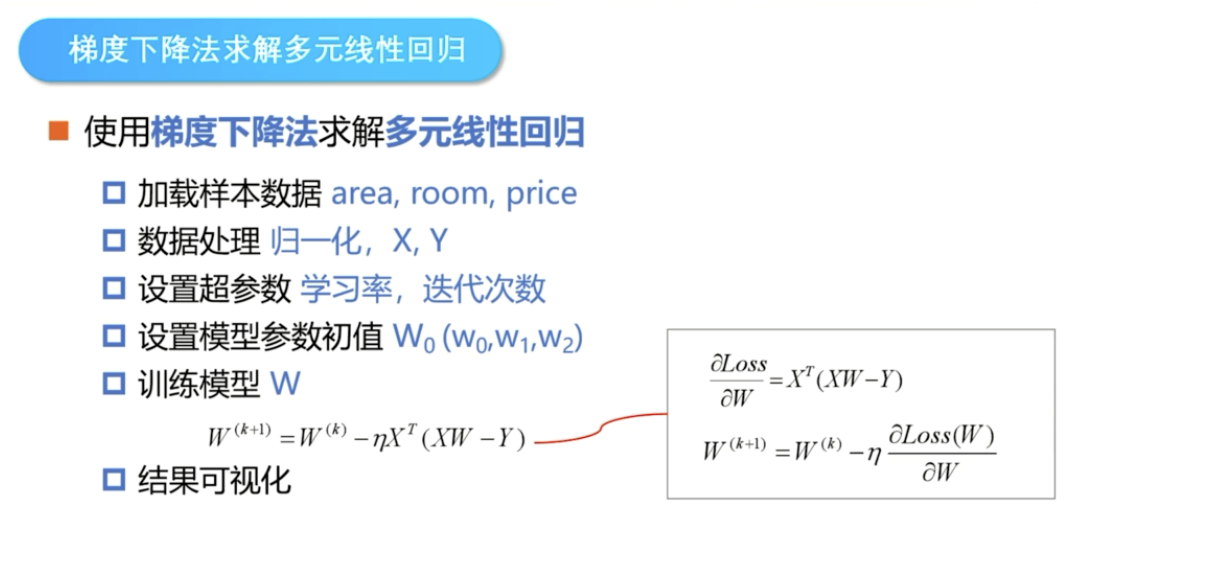
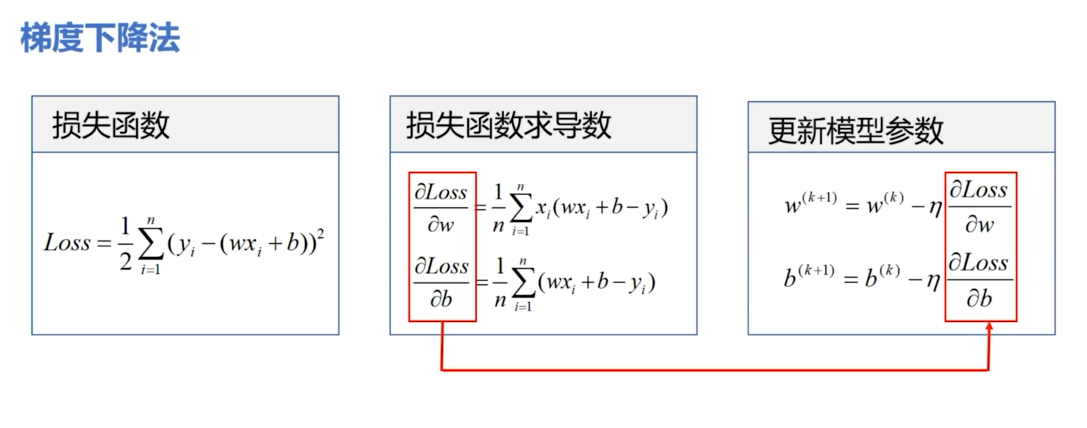
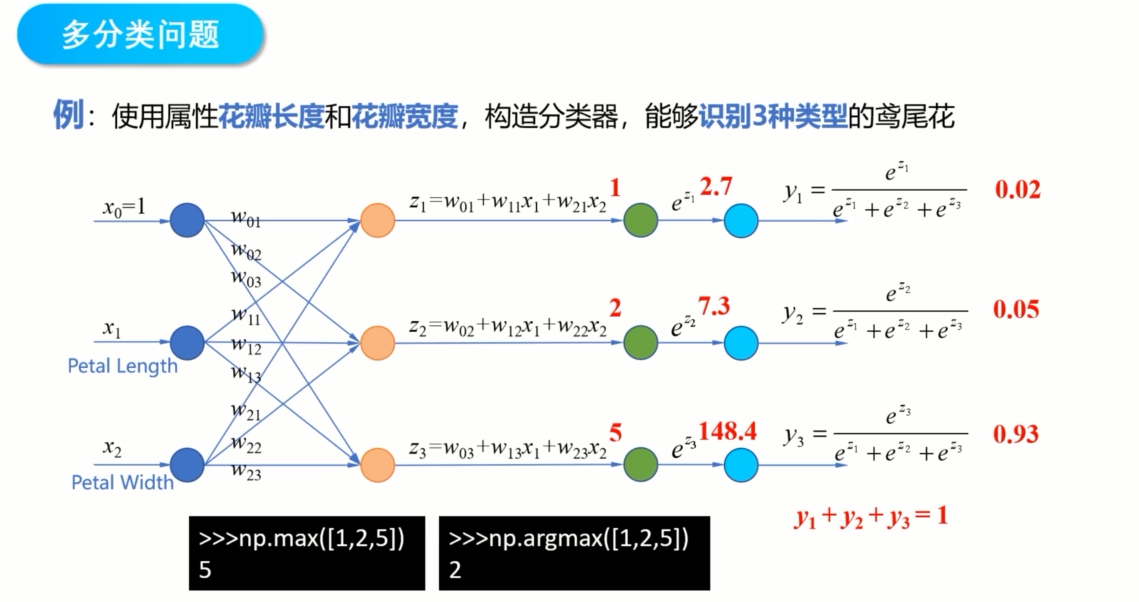
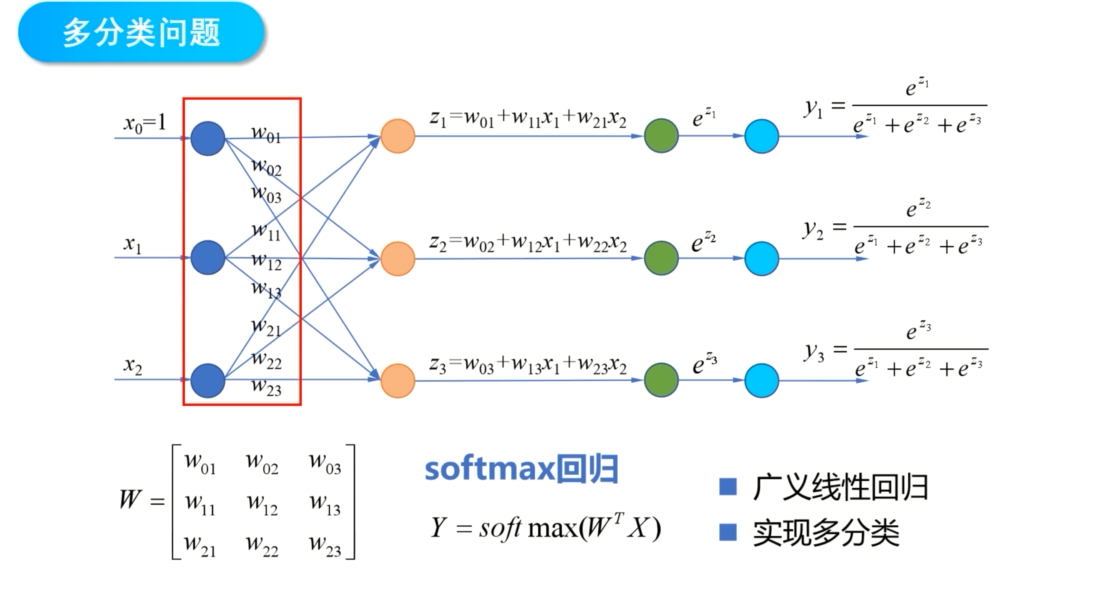
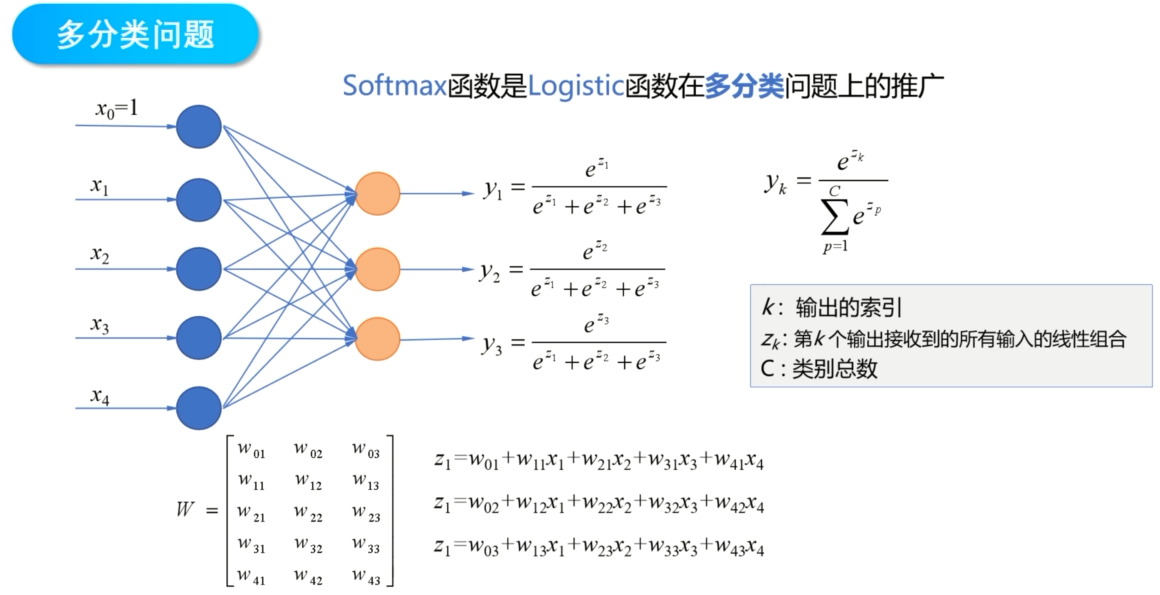
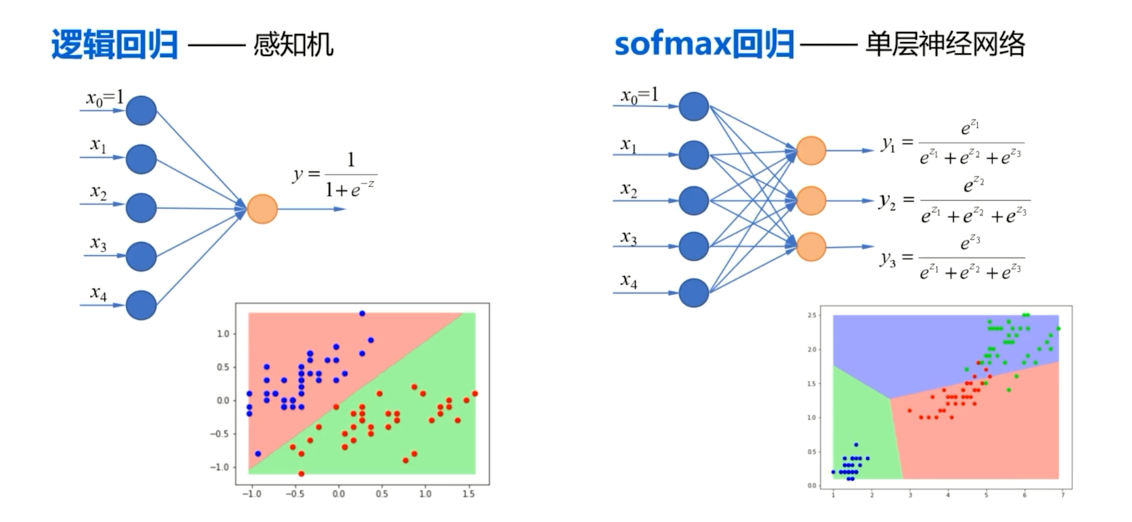
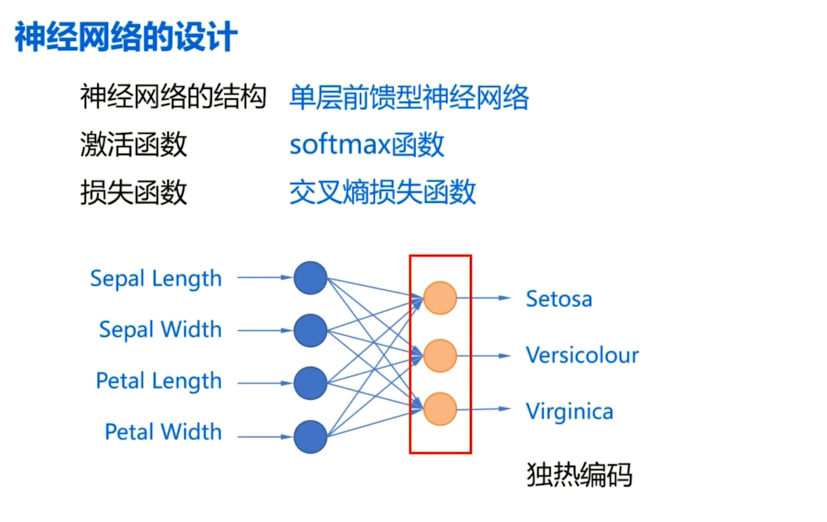
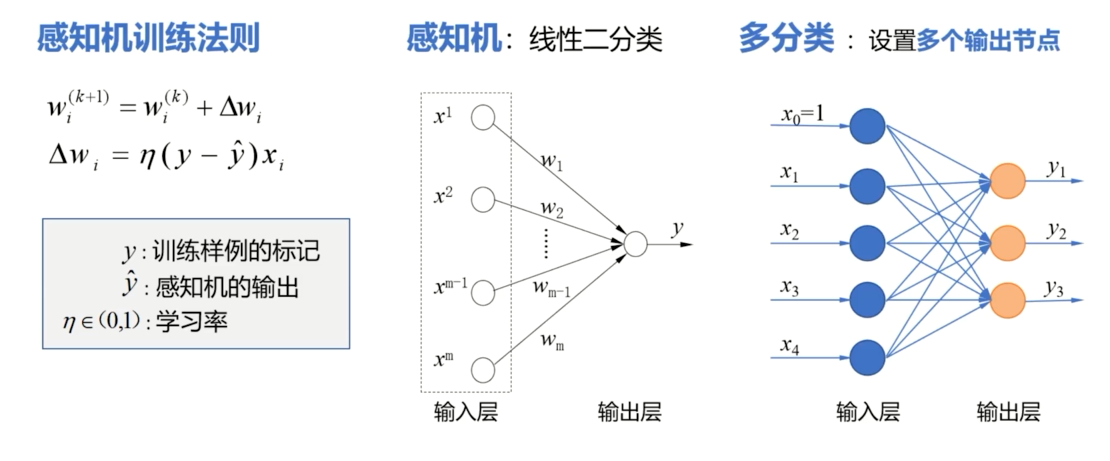
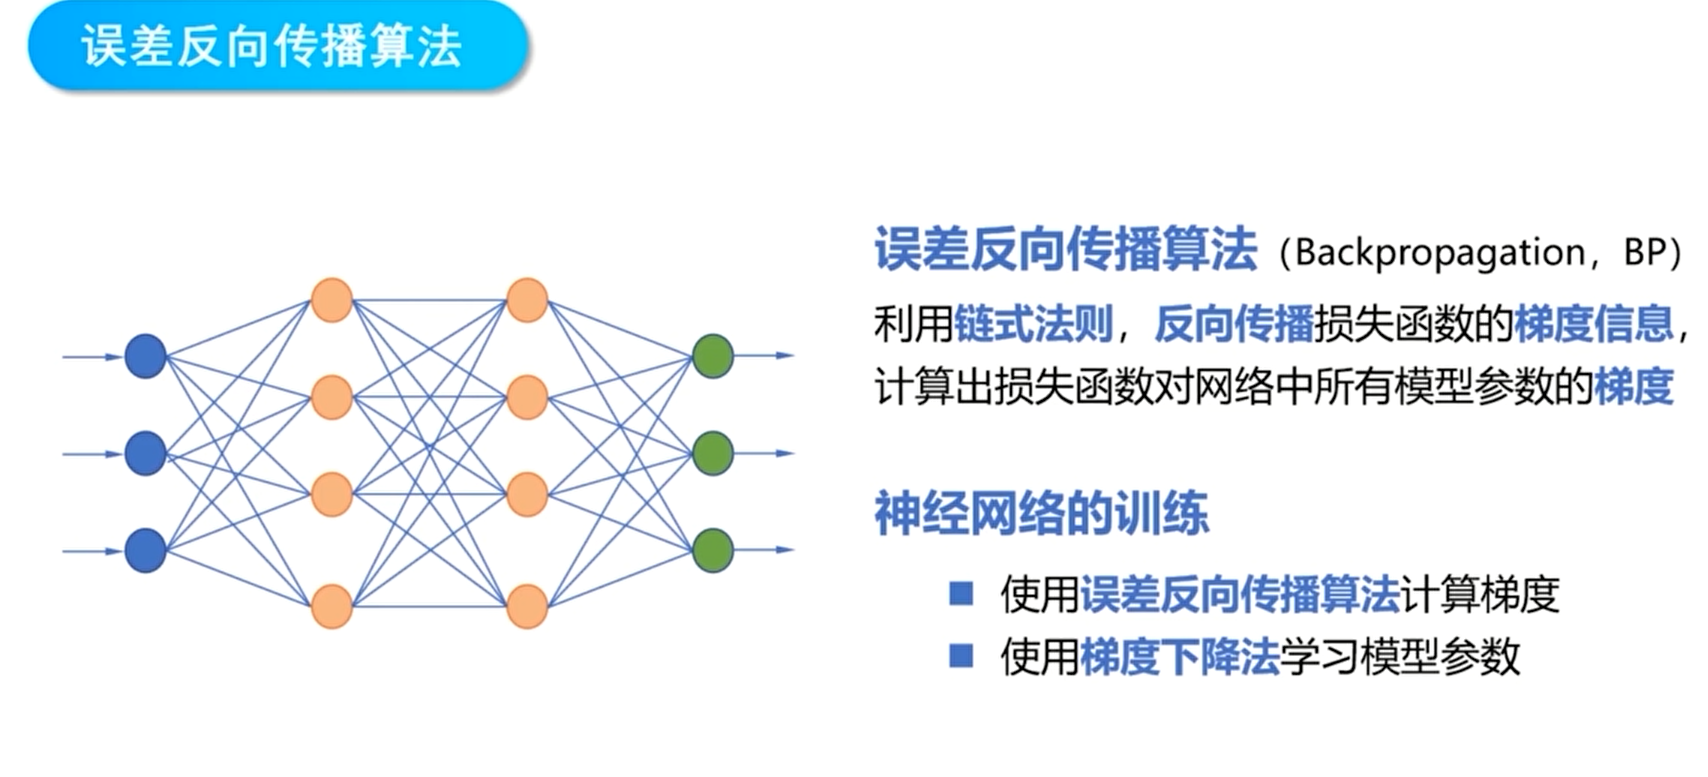
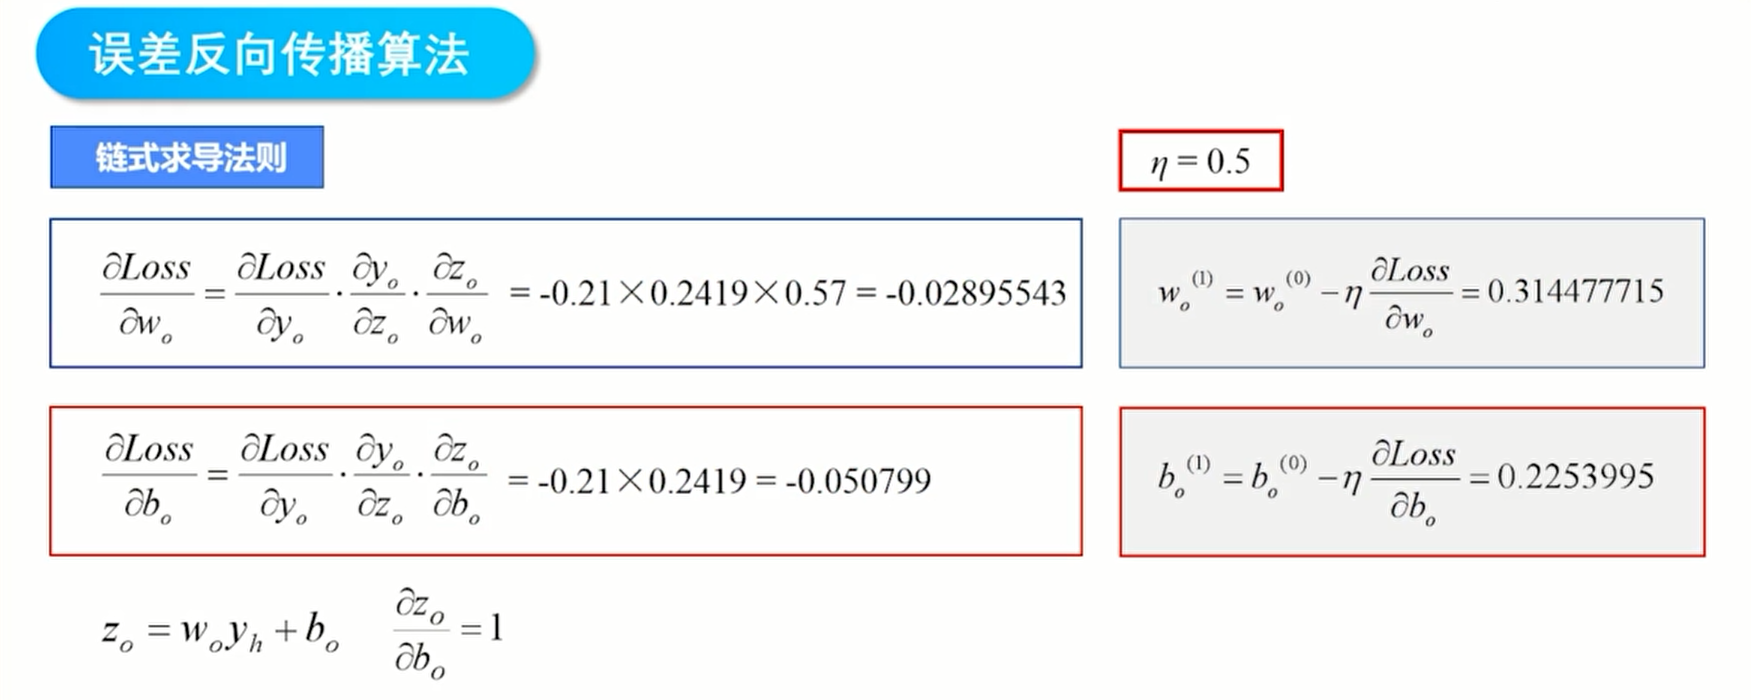
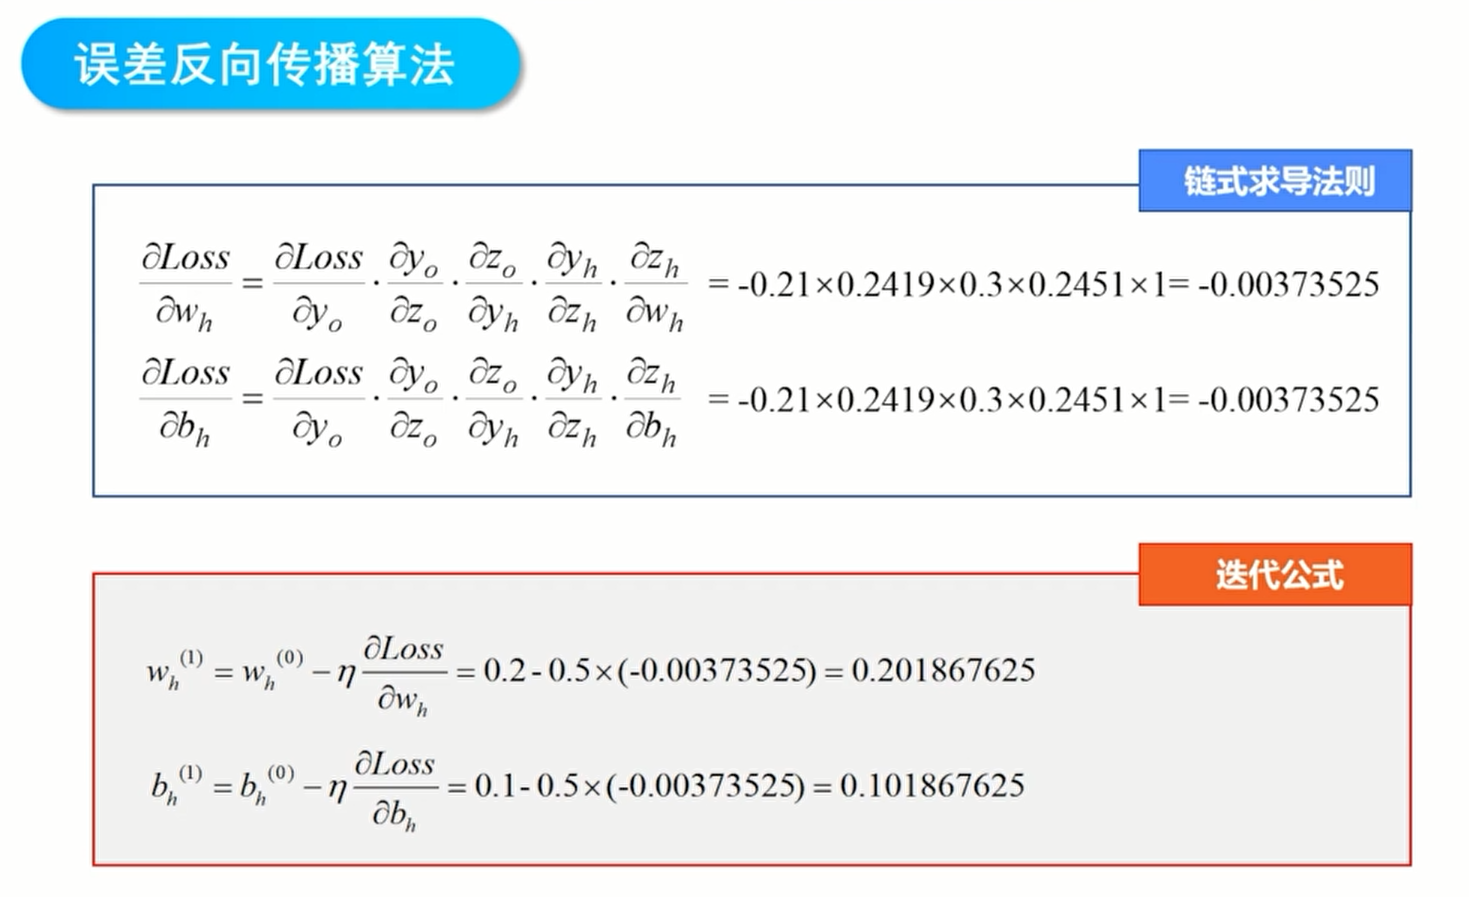
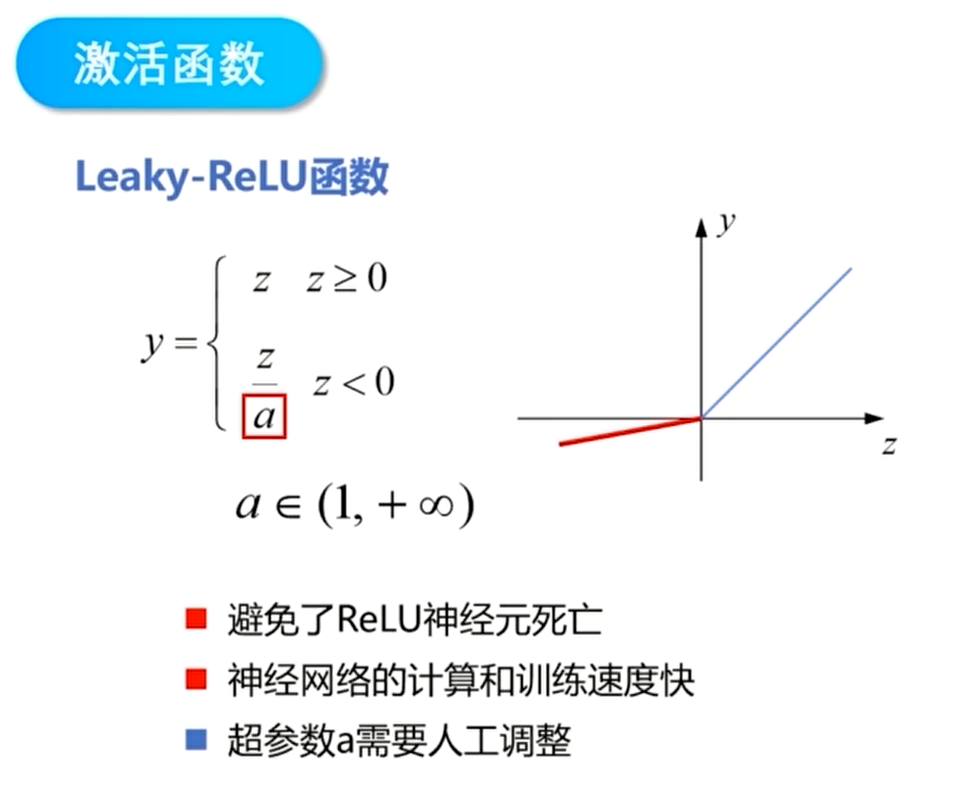
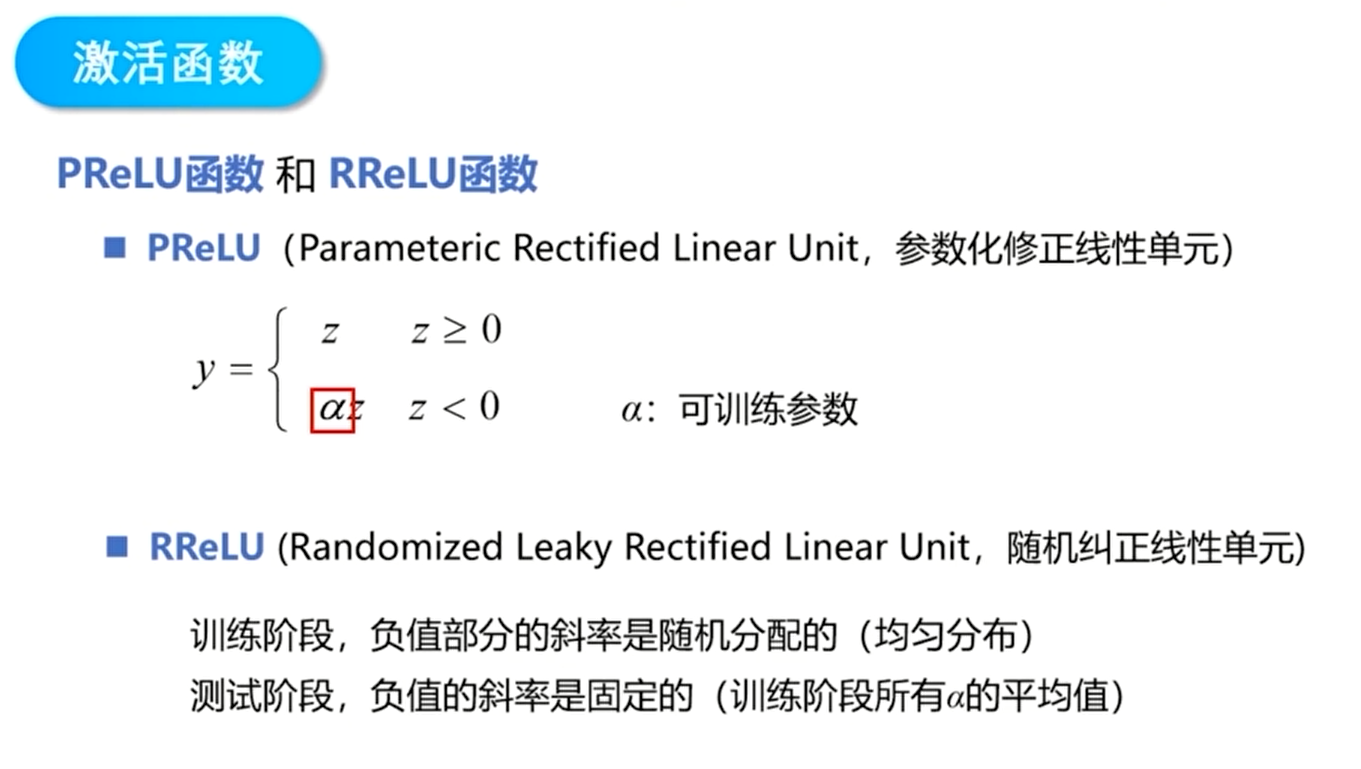
总结:机器学习就是训练出一个函数的结构和参数,也就是模型,然后输入相应的指标数据到这个模型里,这个模型就可以输出对应各种结果的概率或者结果的值。最简单的形式就是线性回归问题。但对于复杂的问题,简单的线性回归无法解决。因此可以引入多个超平面进行组合并加上激活函数,这样就可以对任意空间进行任意的划分,从而解决复杂的问题。而这个超平面就是神经网络里的神经元。对于二分类问题,输出层的激活函数可以使用sigmoid函数,多分类问题可以使用softmax。同时,简单的线性回归问题可以通过直接计算损失函数的最小值来得到精确解。对于复杂问题难以直接通过推导计算得到损失函数最小值的解析解,所以可以使用梯度下降法学习得到模型参数的数值解,在这个过程中可以使用链式求导法则和误差反向传播算法计算梯度。由于sigmoid的导数值在0到1之间,在多层神经网络中会存在梯度消失的问题,所以隐含层的激活函数一般使用ReLU函数(leaky-ReLU, PreLU, RReLU……)。然后是一些优化点,对于大量的训练数据,为了增加训练速度,也为了增加模型的泛化能力,梯度下降法可以使用小批量随机梯度下降法。为了防止陷入局部极小值点或鞍点等问题,可以使用动量梯度下降法,防止越过全局最小值,可以使用牛顿加速梯度算法。也可以使用RMSprop和AdaDelta等自适应调整学习率。也可以通过dropout来增加训练速度和提高模型泛化能力。最后是类似于图像识别和语音识别等问题,可以使用卷积神经网络。利用卷积层,池化层(可以不要),先进行特征提取,然后在使用全连接网络进行分类识别。